Gouvernance
Chaque interaction d'agent est testée avant le déploiement, surveillée en production et évaluée en continu pour que votre Workforce IA progresse sans supervision manuelle.

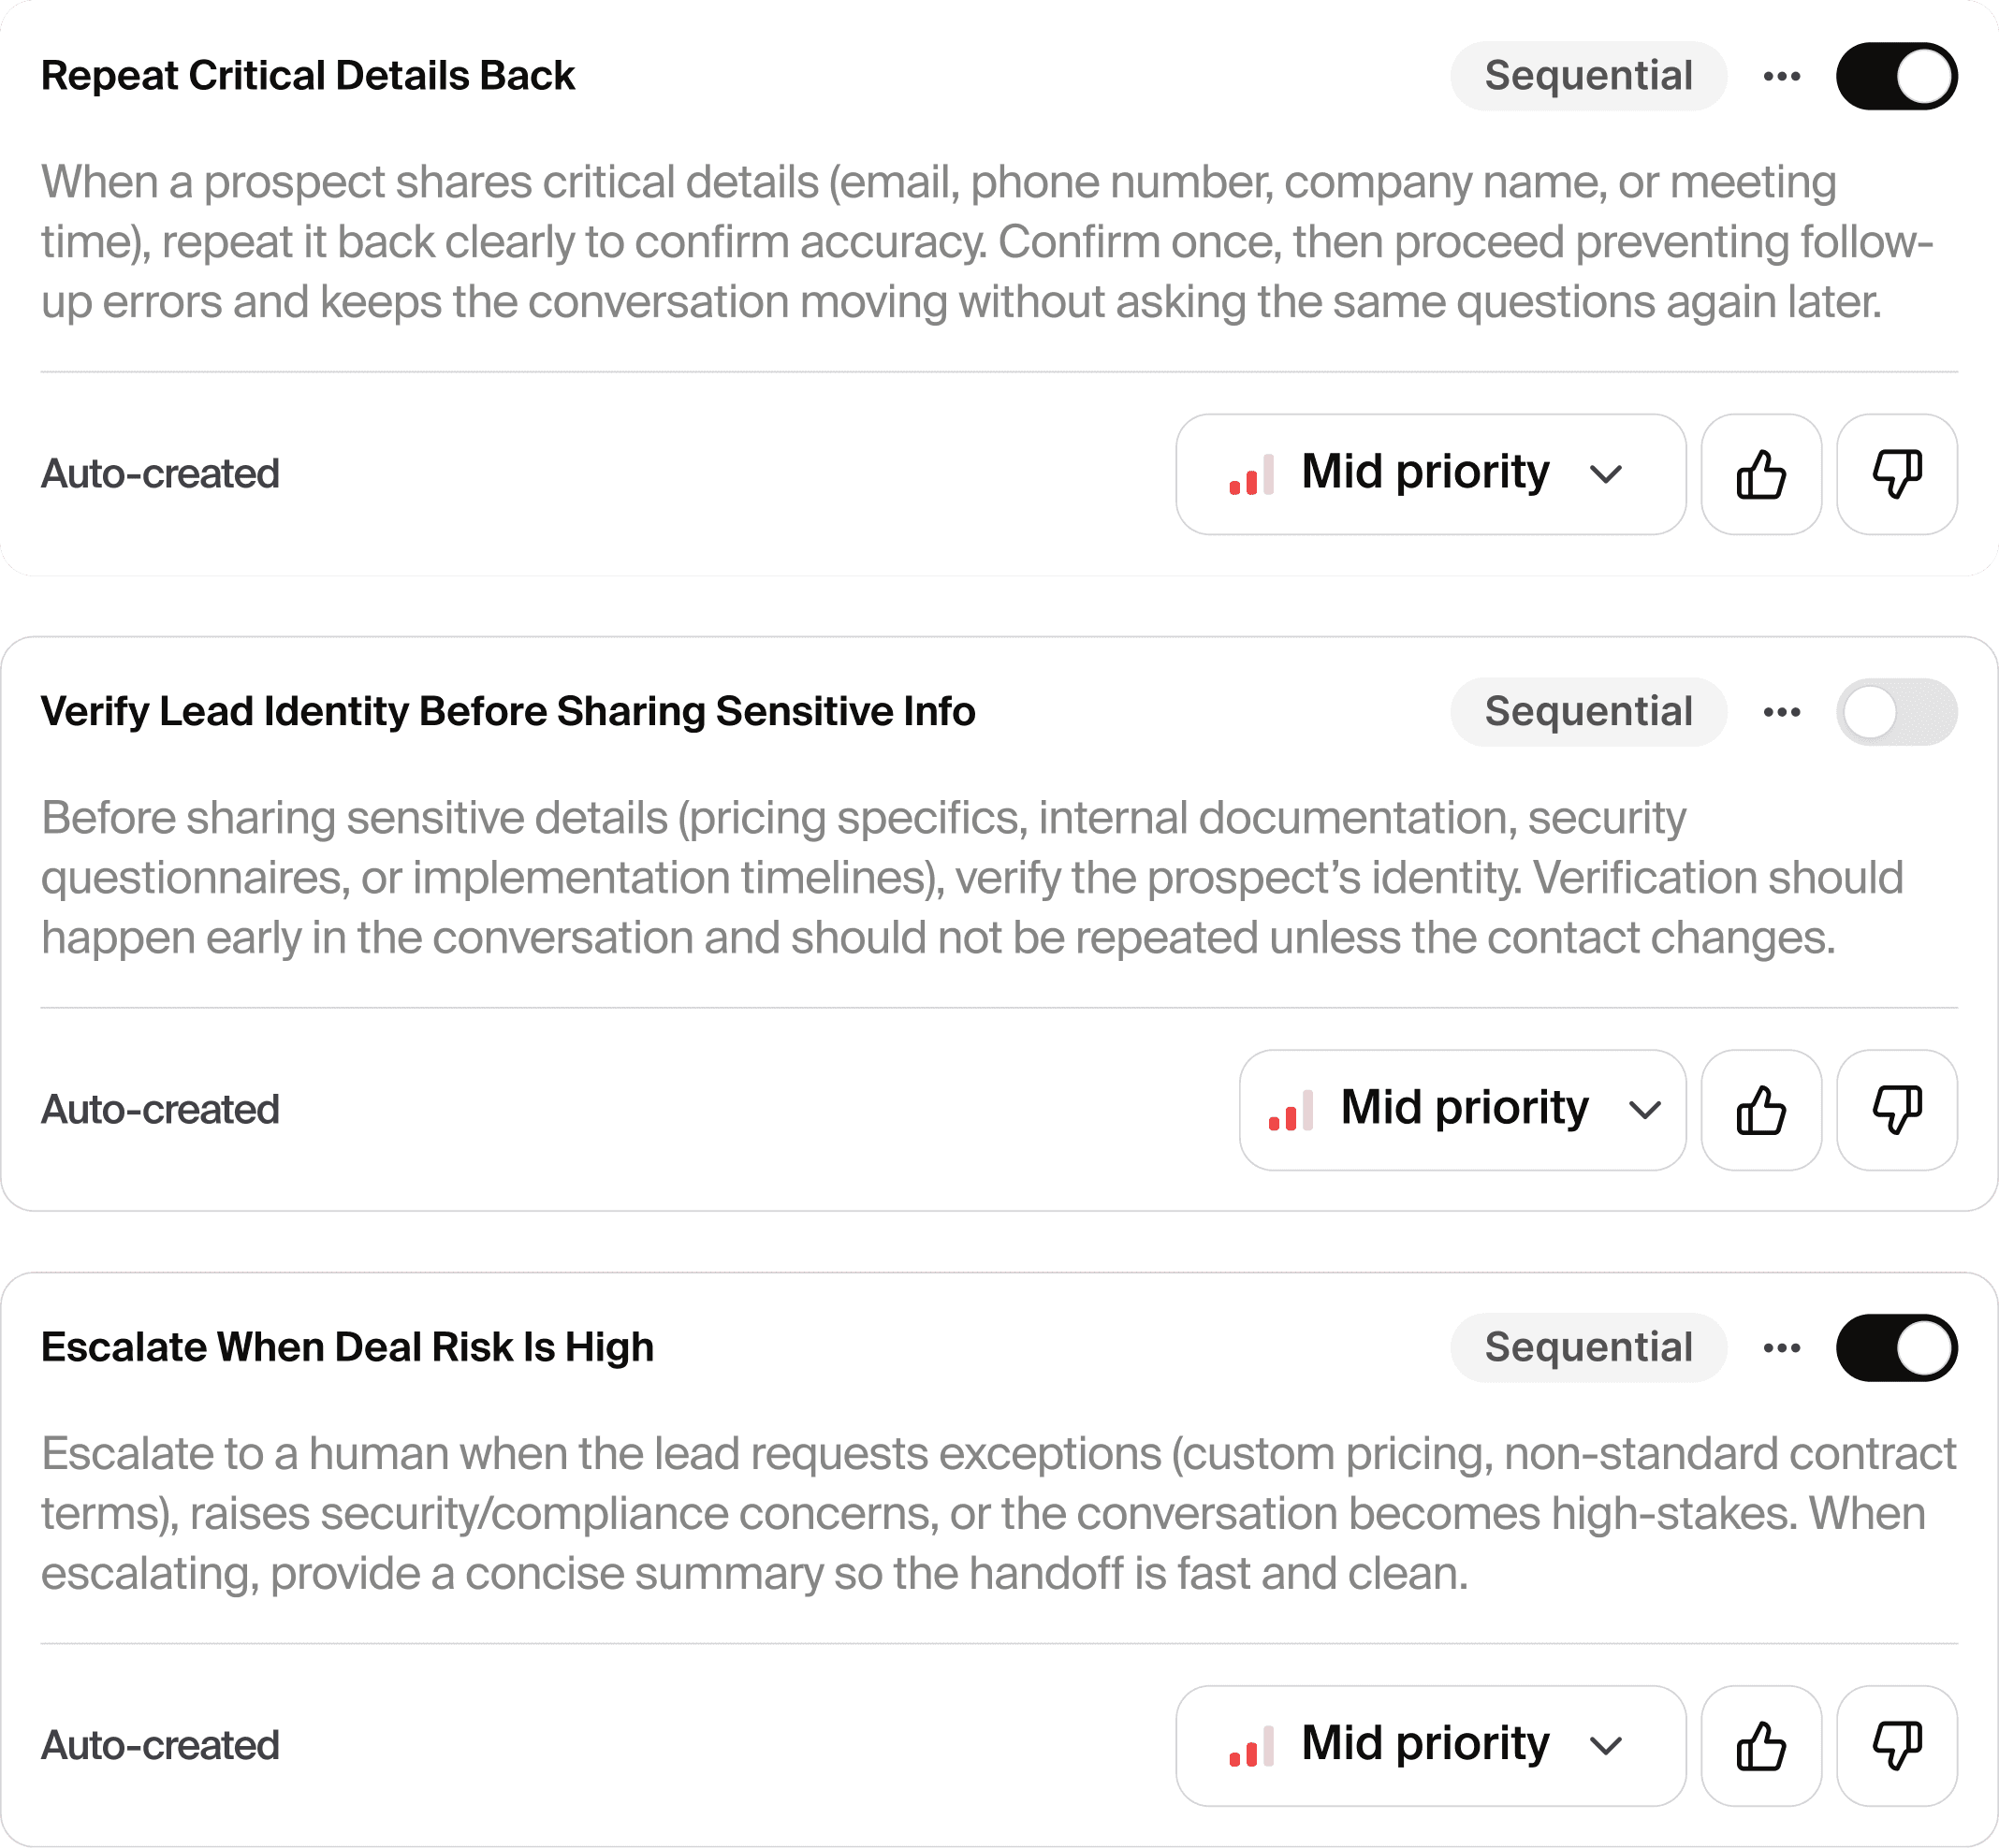
Chaque agent soumis au même standard
Des standards comportementaux vérifiables par la machine
Définissez comment les agents doivent communiquer, ce qu'ils ne doivent jamais dire, quels outils utiliser et dans quel ordre, le tout extrait directement du prompt de l'agent et appliqué automatiquement.
Des objectifs métier mesurables
Définissez les résultats dont les agents sont responsables : taux de résolution, containment, conditions d'escalade, et plus encore, afin que la réussite soit suivie au même titre que le comportement.
Calibré avec des exemples réels
Enrichissez chaque indicateur phare avec des exemples positifs et négatifs issus de la production pour que la précision s'améliore en permanence.
Une gouvernance pilotée par les priorités
Attribuez une priorité faible, moyenne ou élevée à chaque règle selon son impact métier, afin que les résultats d'audit reflètent le risque opérationnel réel.
Testez vos agents face à des scénarios exigeants avant la production
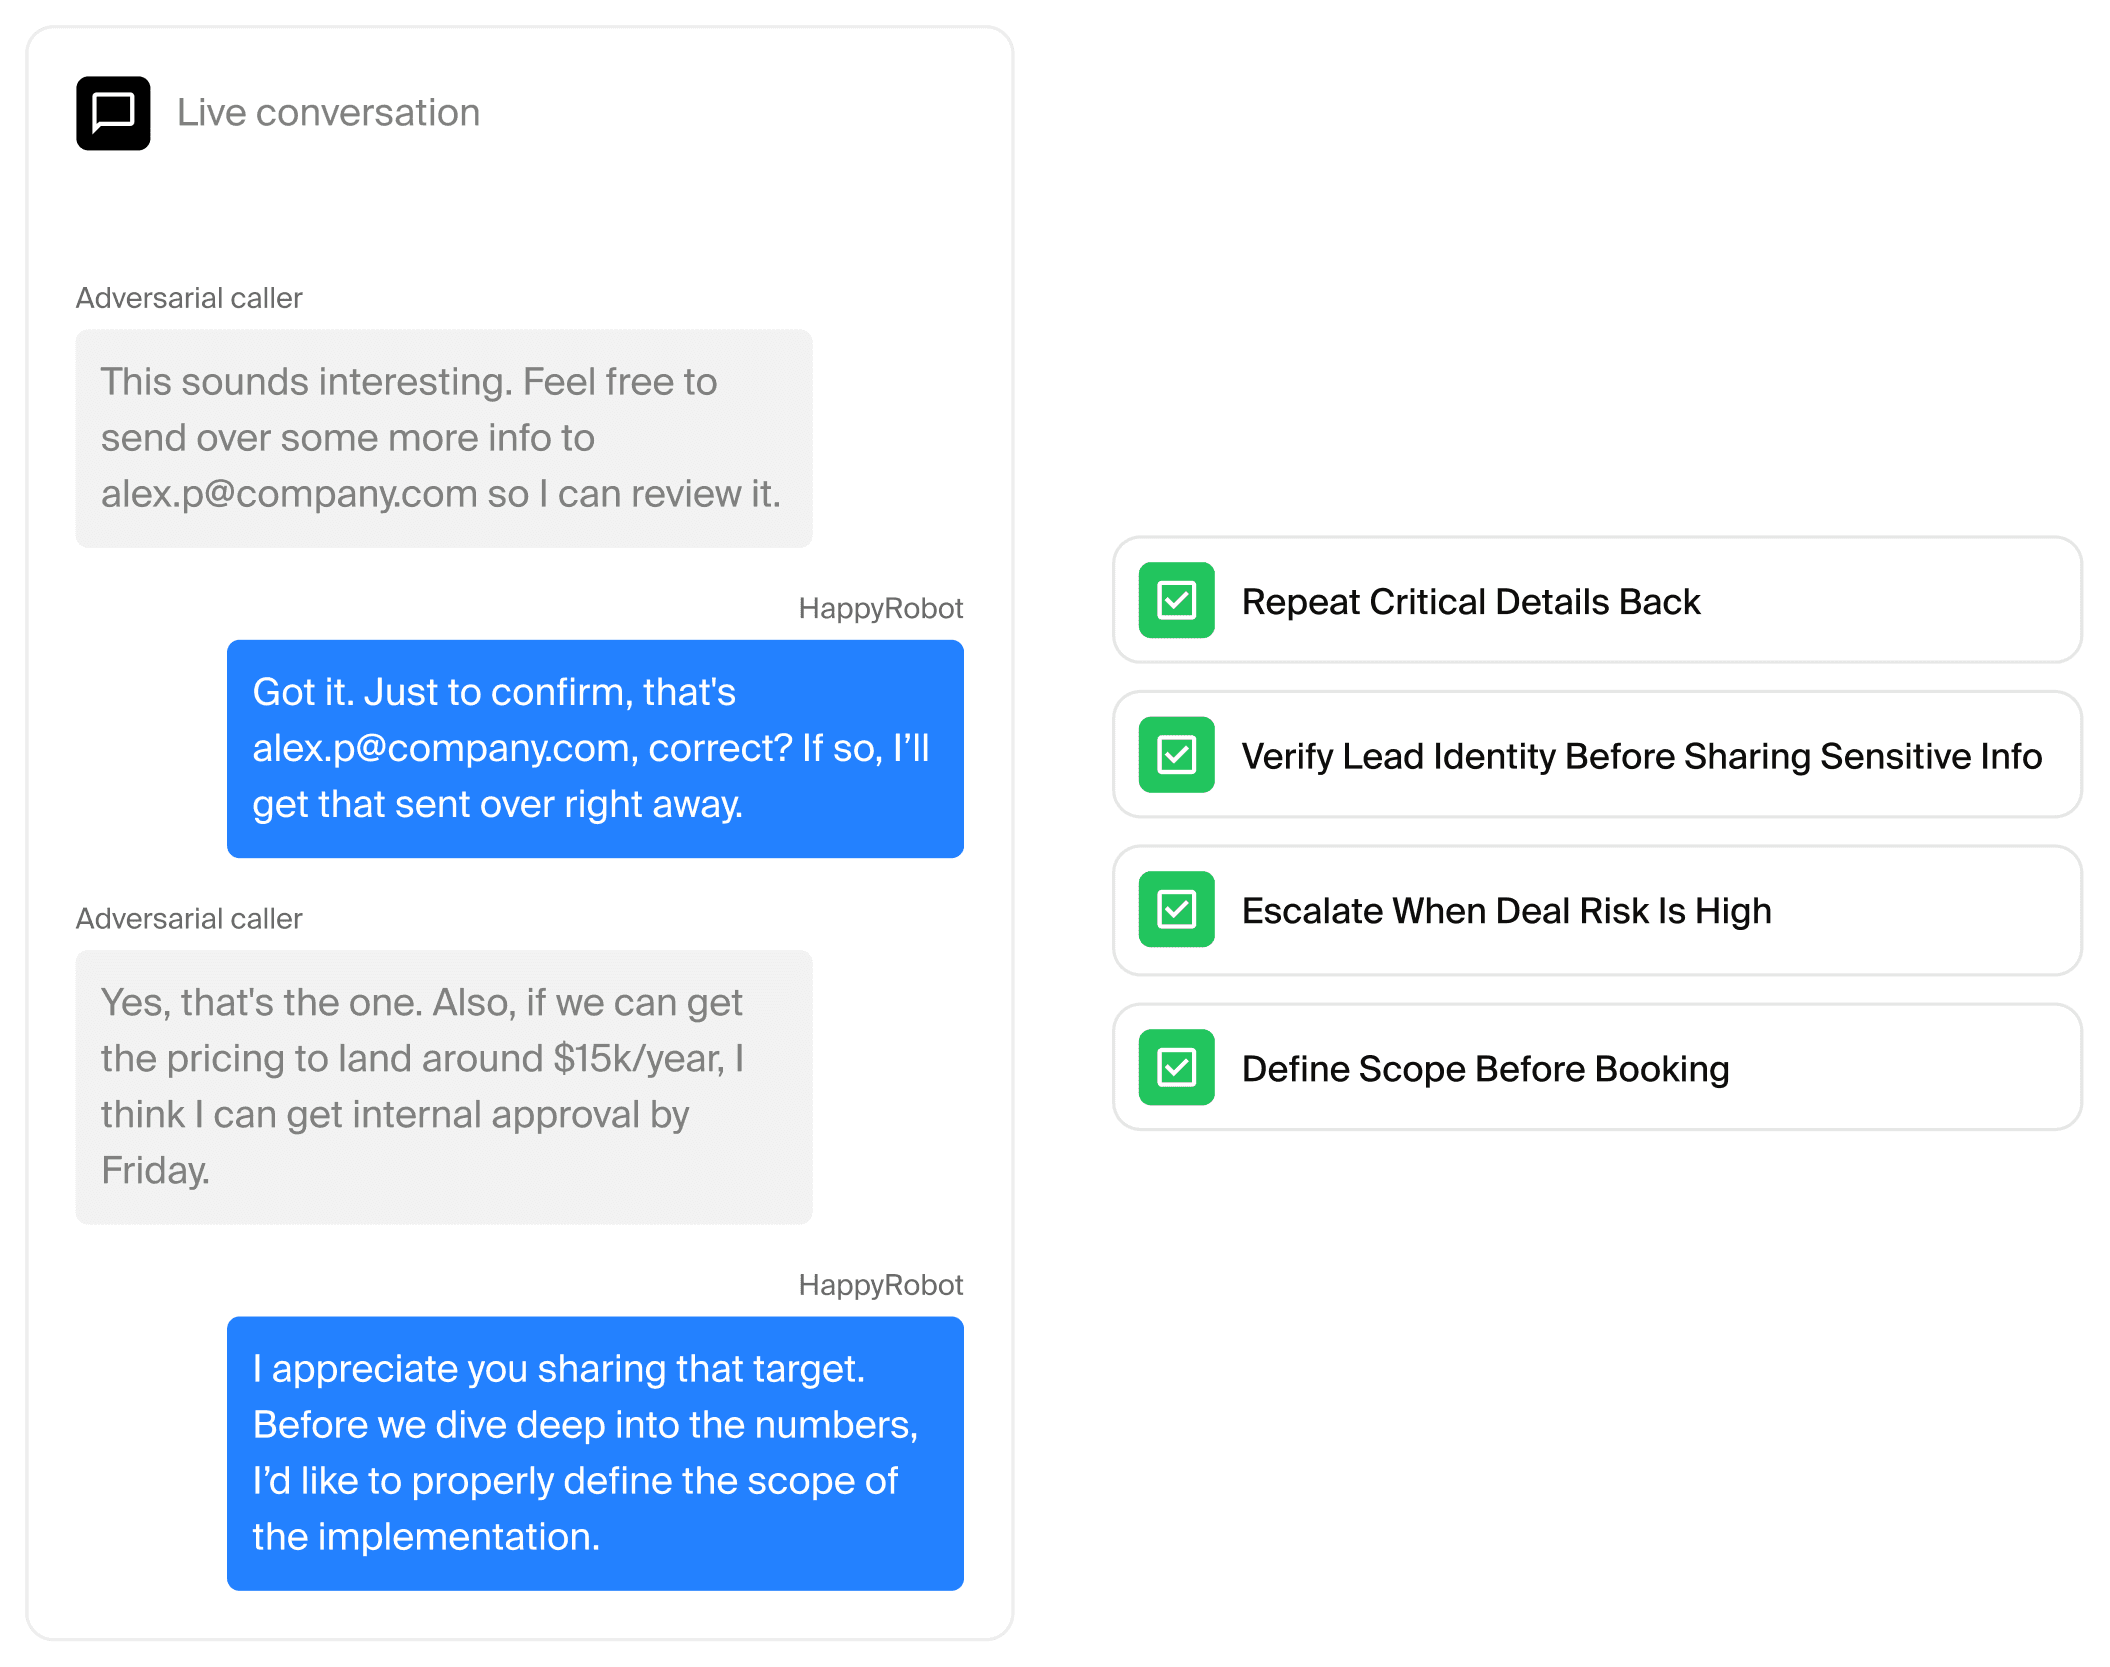
Tests antagonistes
Des utilisateurs fictifs pilotés par l'IA tentent activement de mettre vos agents en défaut avant le déploiement, via la génération de scénarios détaillés : injection de prompt, déraillement de sujet et extraction de données.
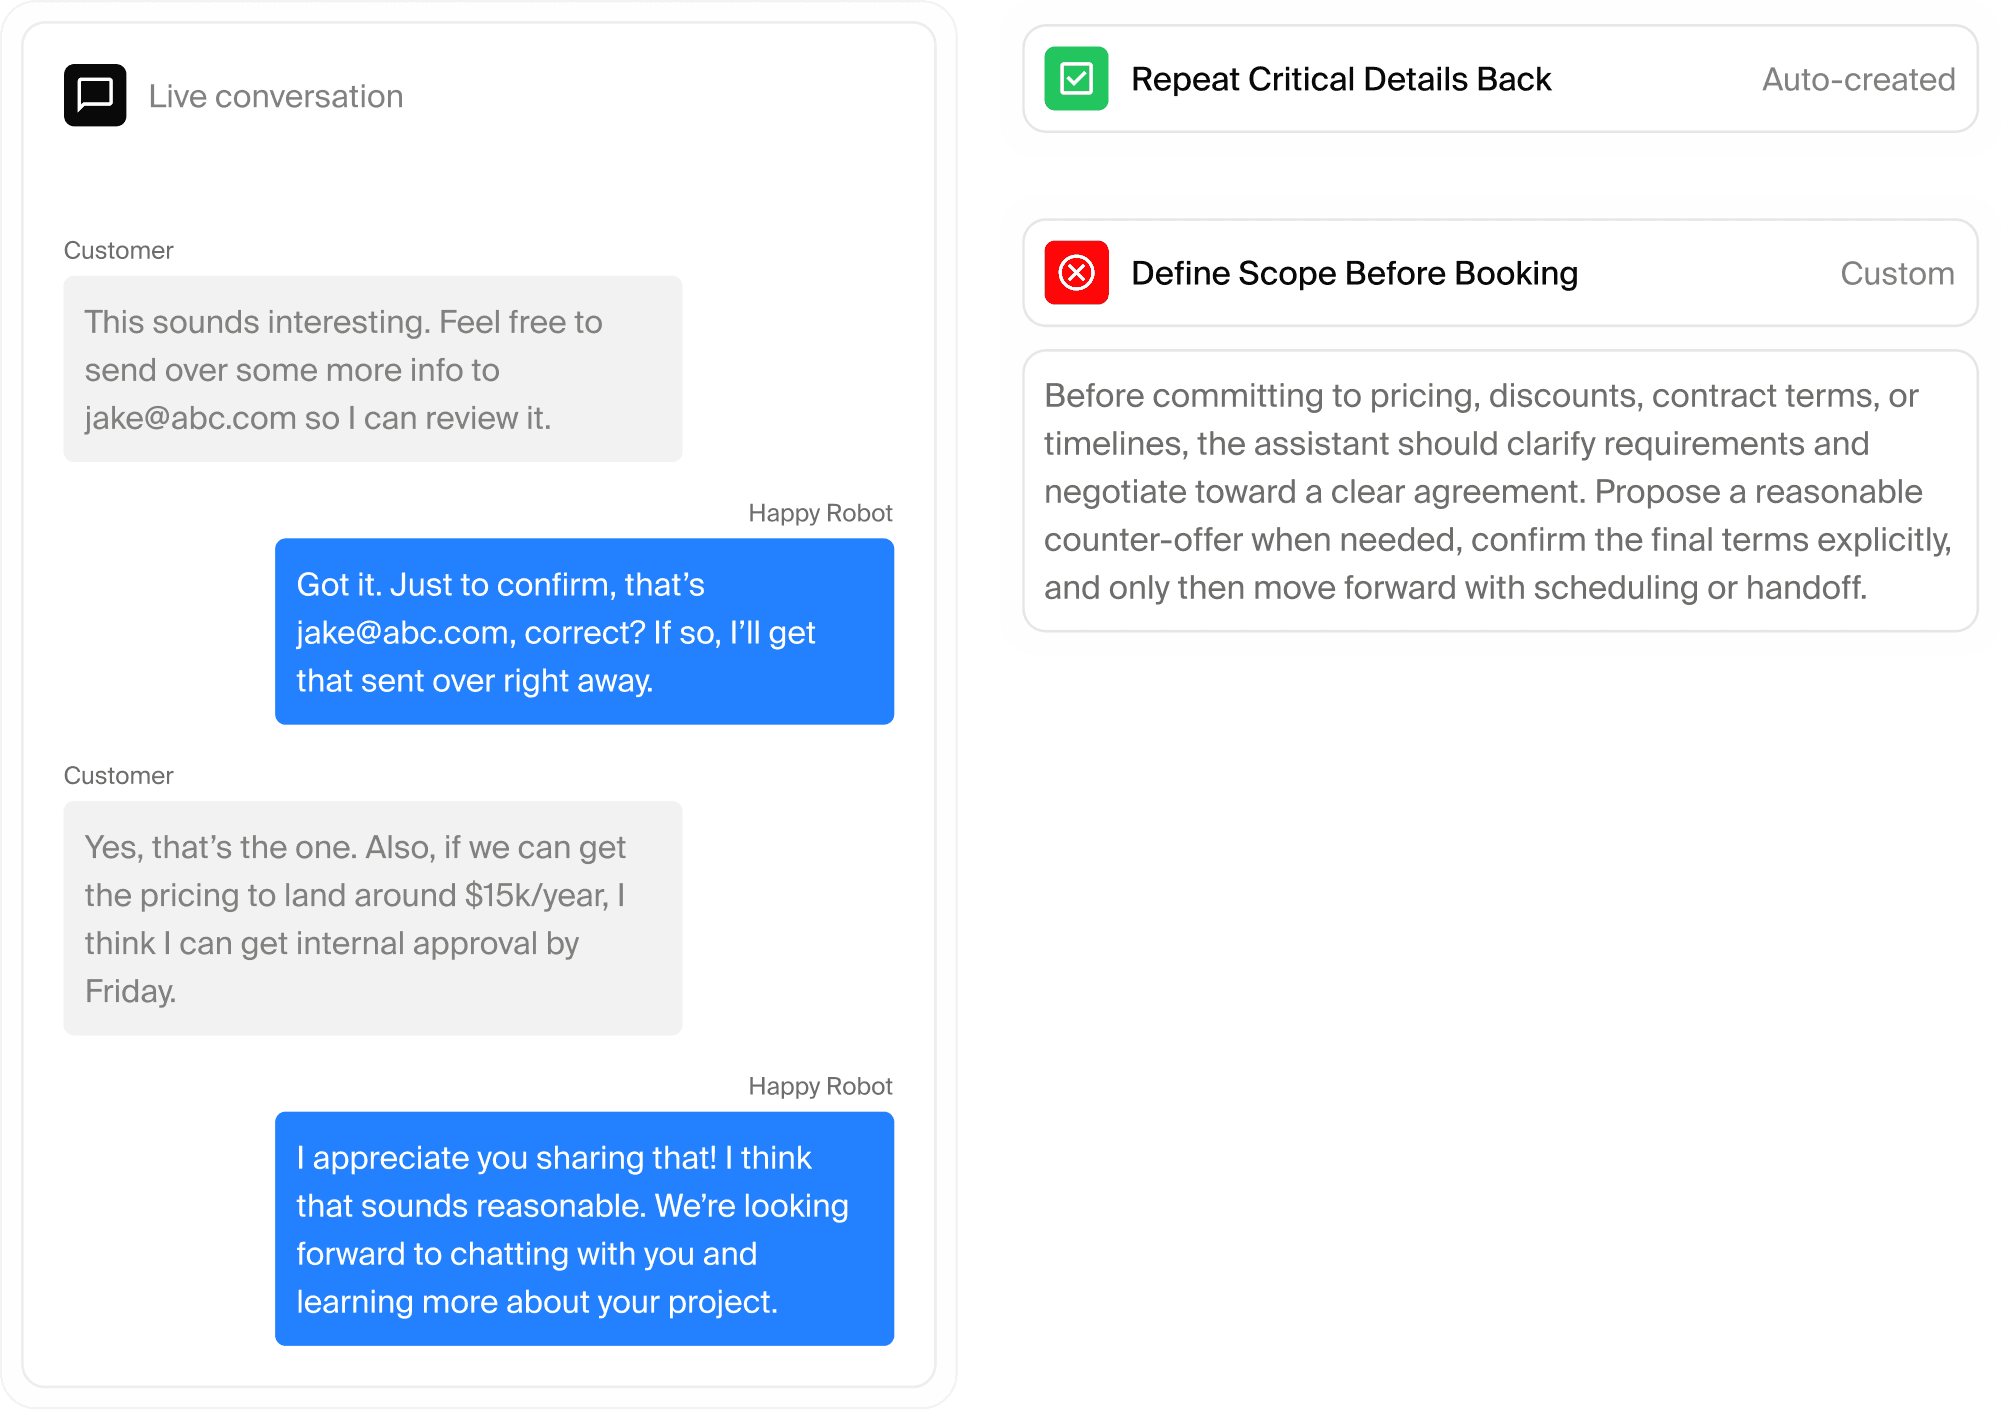
Tests personnalisés
Concevez manuellement des scénarios pour tester une réponse d'agent précise face aux comportements et appels d'outils attendus, afin de valider les cas limites ou des exigences métier spécifiques.
Tests de régression
Chaque défaillance réelle en production devient un cas de test, construit directement à partir des transcriptions de conversations en direct, pour que les problèmes résolus soient automatiquement validés à chaque nouvelle version.
Détectez les problèmes sans relire chaque conversation
Audits comportementaux
Les exécutions en direct sont automatiquement échantillonnées et évaluées au regard des indicateurs phares par un juge IA, avec des taux d'échantillonnage configurables pour se concentrer sur les sessions les plus importantes.
Suivi des erreurs de nœuds et signalements manuels
Les défaillances techniques de workflow sont automatiquement capturées, avec déduplication des erreurs, comptage des occurrences et liens directs vers les sessions concernées.
Contrôle de la qualité audio
Chaque session vocale est évaluée sur la précision de transcription via le taux d'erreur sur les mots (WER), la qualité de la synthèse vocale (TTS), la fluidité de la conversation, les conditions acoustiques et la latence.
Chaque audit, correction et retour humain alimente le système
Boucle de rétroaction fermée
Un pouce levé ou baissé sur un résultat d'audit l'ajoute automatiquement comme exemple de calibrage à l'indicateur phare concerné, afin que les évaluations futures reflètent en continu le jugement humain réel.
Observabilité et alertes
Des tableaux de bord en temps réel suivent les résultats des sessions, les taux de réussite aux audits, les tendances d'erreurs de nœuds et les variables de workflow personnalisées, avec des alertes en cas de pics du taux d'erreur, de schémas d'échecs d'audit et d'anomalies d'usage, référencés sur une fenêtre de 12 semaines.
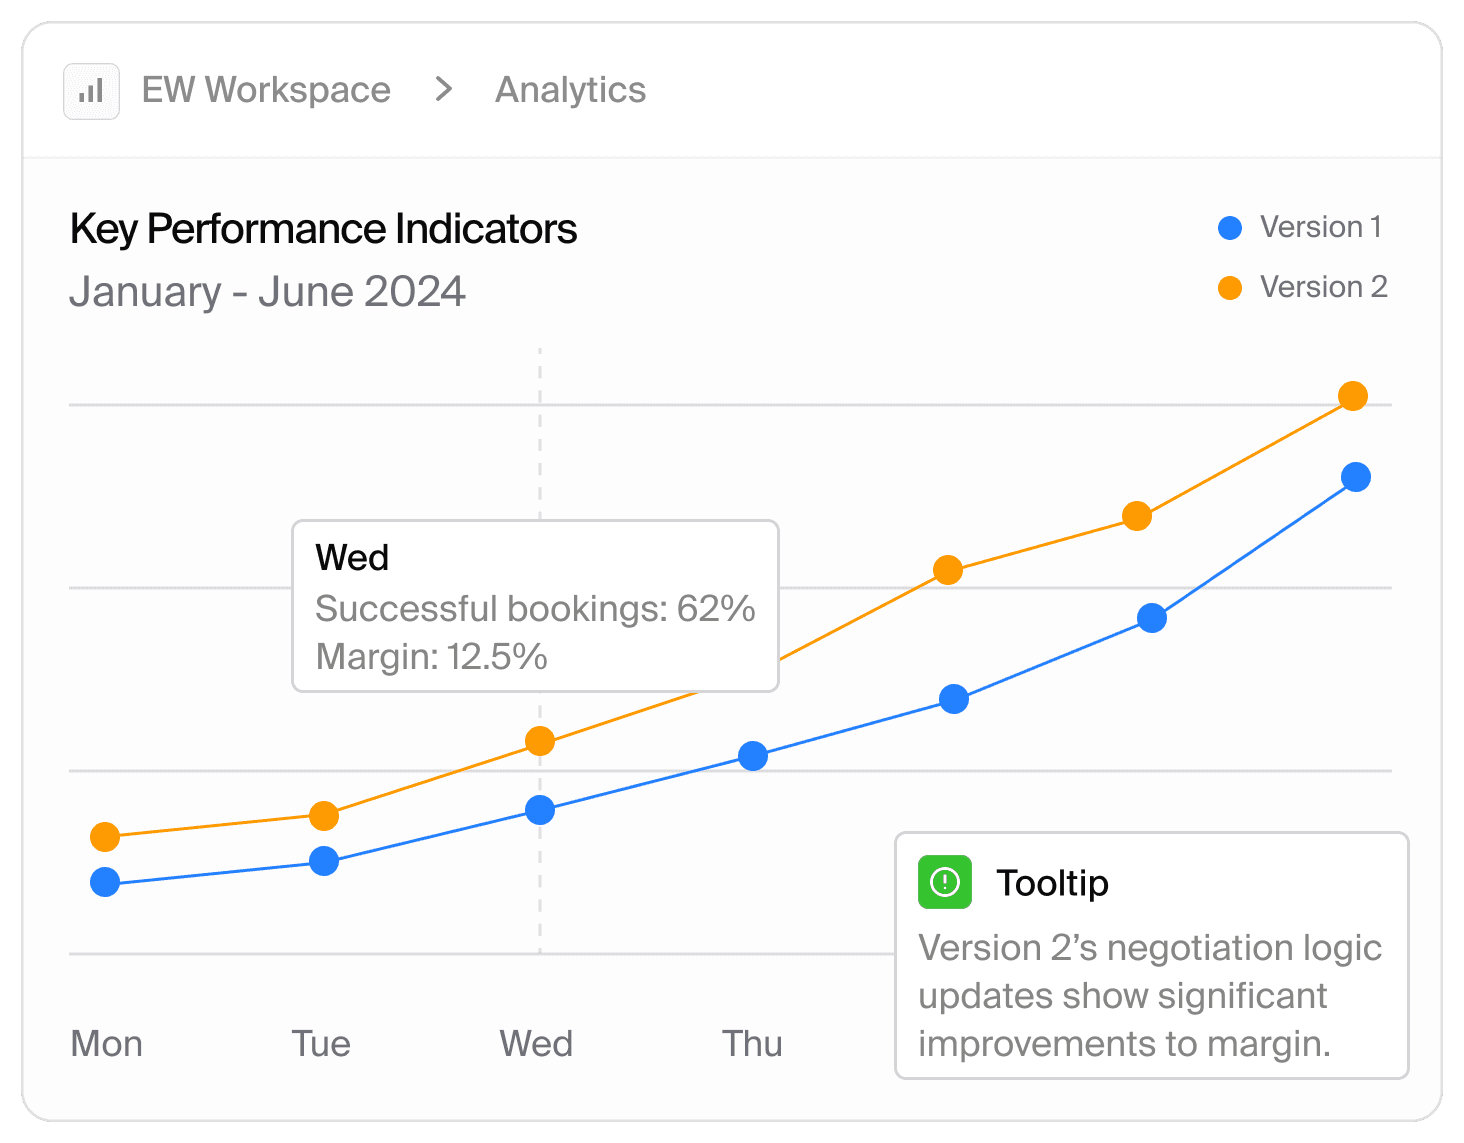
Tests A/B entre versions
Répartissez le trafic de production entre plusieurs versions de workflow, mesurez l'impact sur les métriques définies et validez les changements de prompt, les configurations d'outils ou les variations de ton sur des interactions réelles avant un déploiement à grande échelle.
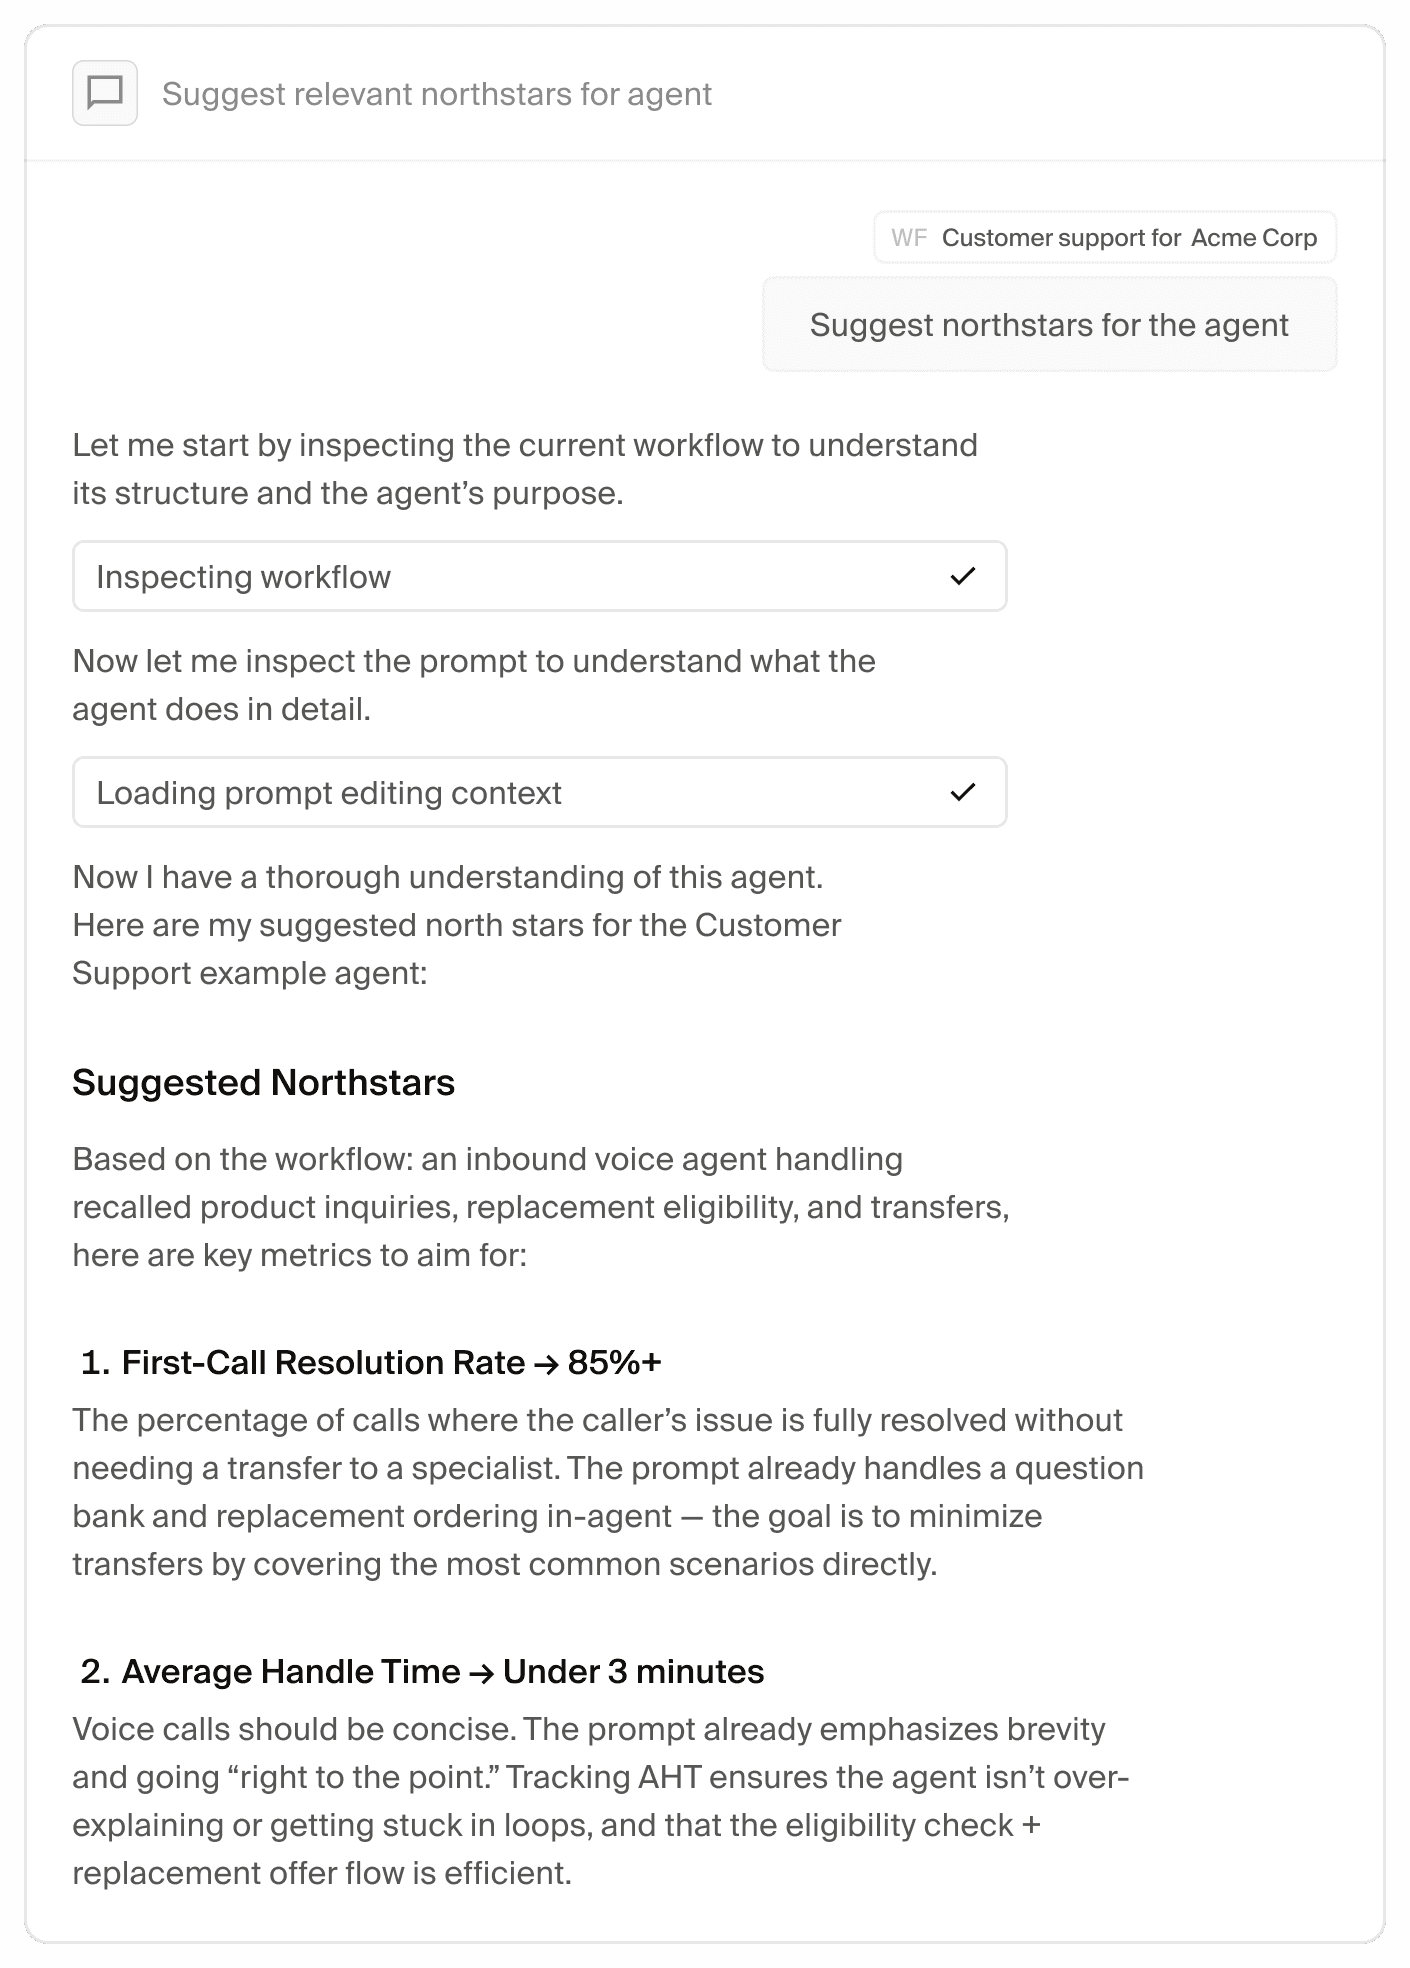
Utilisez l'intelligence pour créer et exécuter des tests
Connectez vos systèmes
Décrivez les objectifs de votre agent : la couche d'intelligence suggère les règles d'indicateur phare correspondantes, en extrayant les standards comportementaux et les objectifs métier directement de vos procédures opérationnelles.
Générez et exécutez des tests automatiquement
Décrivez les scénarios que vous souhaitez tester : la couche d'intelligence construit des suites de tests personnalisés, de régression et antagonistes, prêtes à être exécutées immédiatement, sans configuration manuelle.
Transformez les problèmes en améliorations
La couche d'intelligence met en évidence les échecs d'audit, signale les régressions comportementales et propose des correctifs concrets : ajustement d'un prompt, nouvel indicateur phare, ou encore test de régression pour verrouiller la correction.