Une stack vocale propriétaire pour des conversations d'un naturel humain
Un pipeline vocal spécialement conçu pour l'imprévisibilité des appels réels en entreprise
Pourquoi l'IA vocale de HappyRobot est différente
Notre TTS
La plupart des solutions d'IA vocale sont conçues pour des conditions contrôlées. La téléphonie d'entreprise ne l'est pas : les interlocuteurs ont des accents, il y a du bruit de fond, une terminologie métier spécifique, et aucune patience pour des réponses robotiques ou des silences gênants. Le pipeline vocal de HappyRobot est une stack de 10 modèles dont chaque composant est affiné spécifiquement pour la téléphonie en direct à l'échelle de l'entreprise, et non adapté d'un produit grand public généraliste.
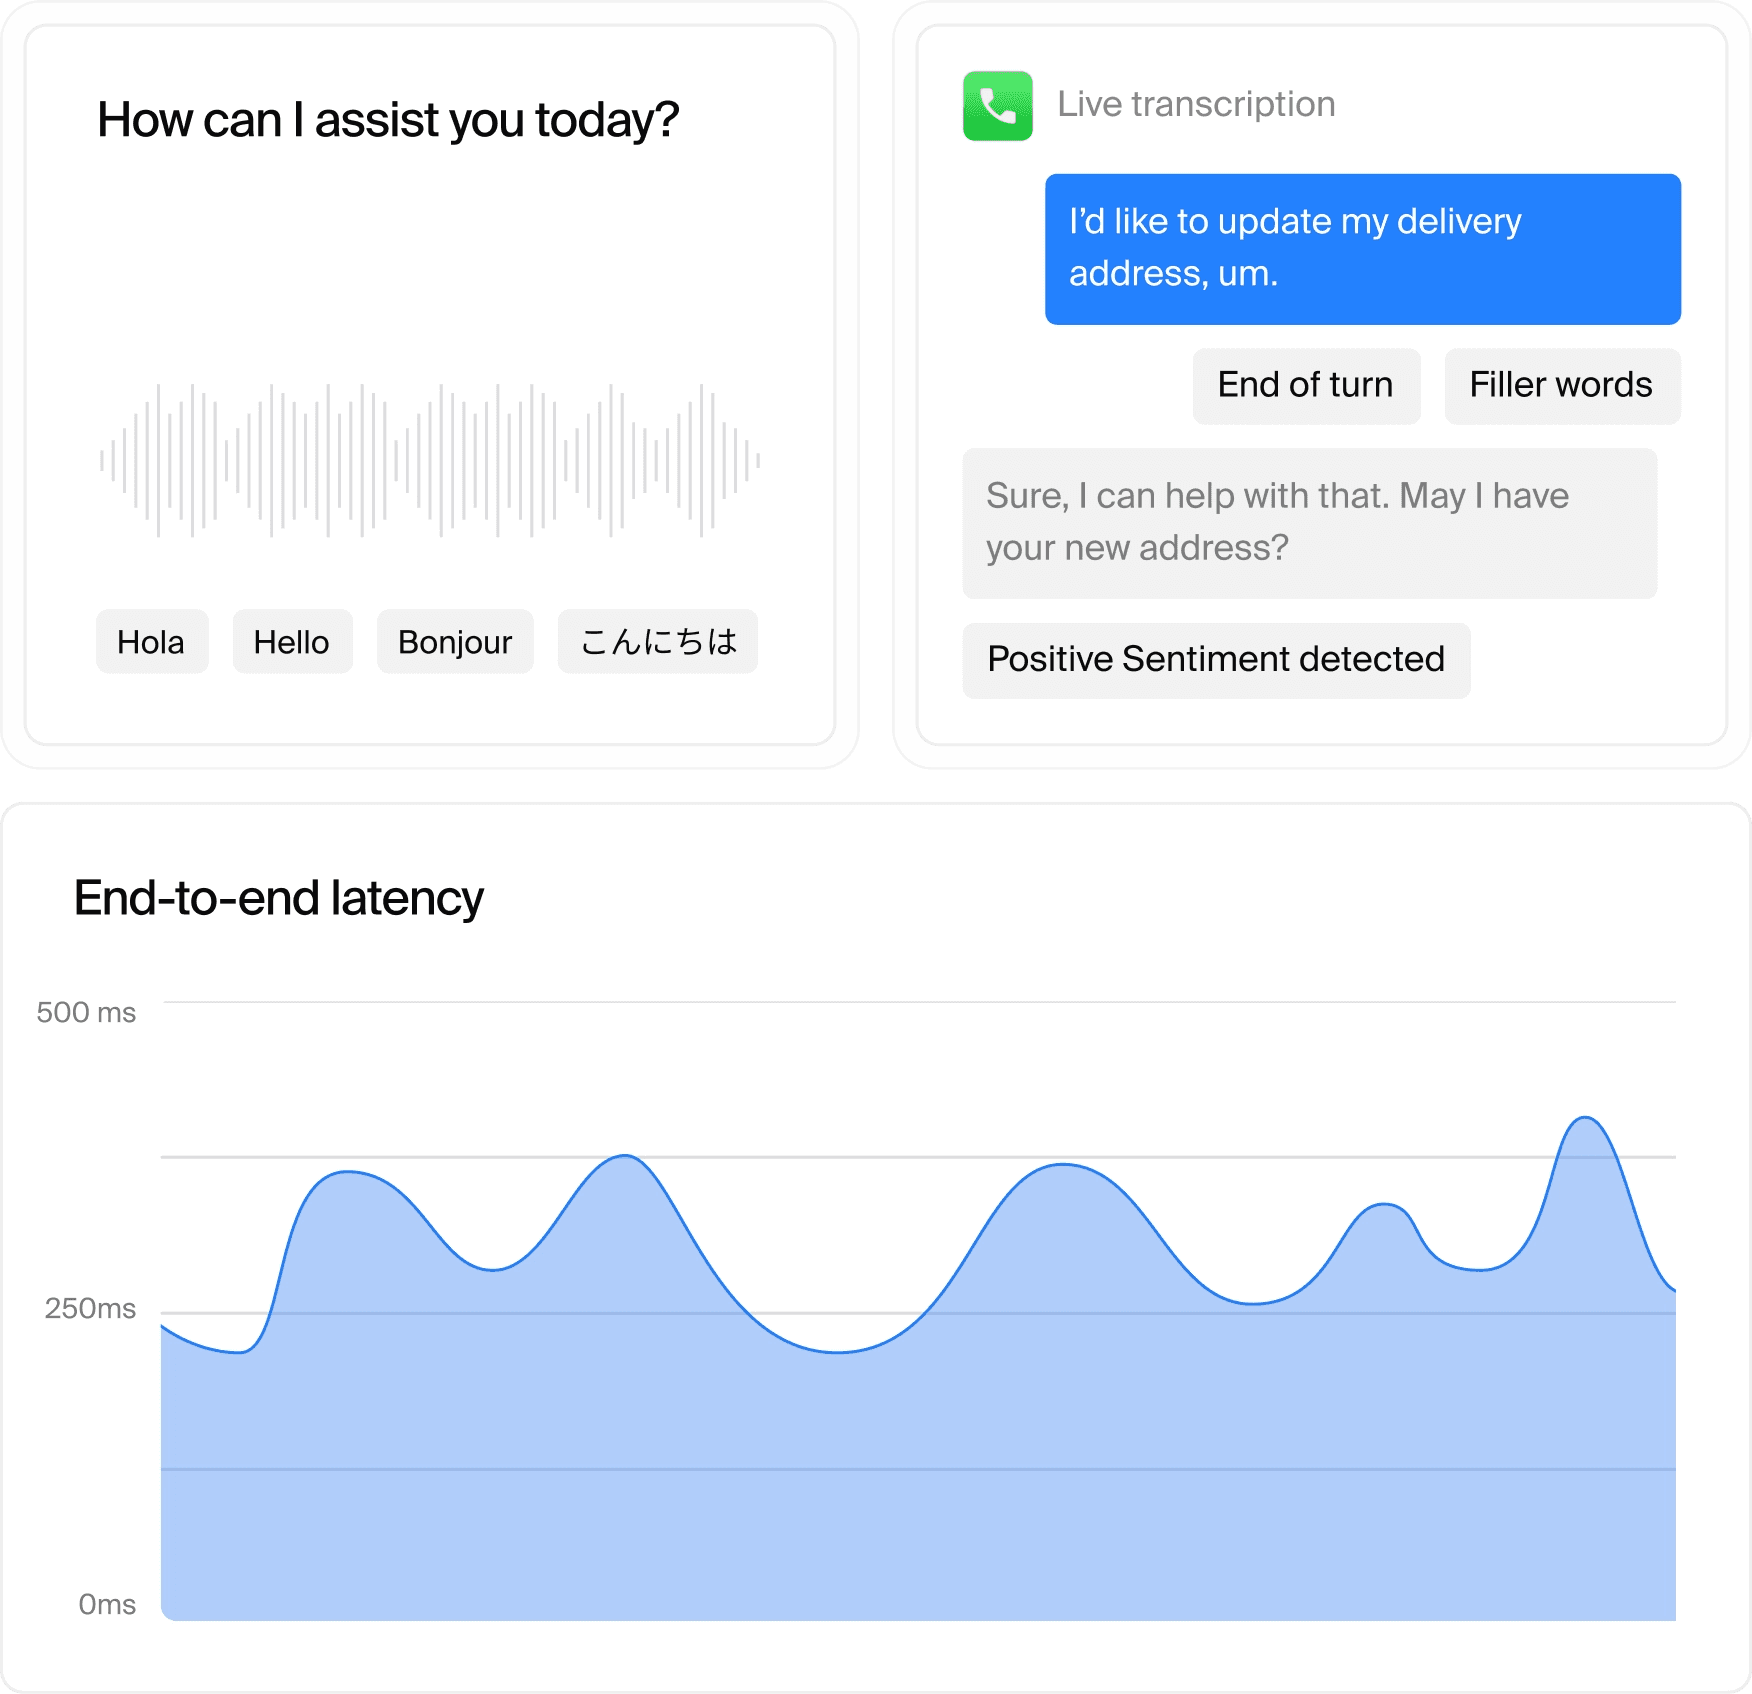
Les échanges d'un véritable appel, sans rupture de fluidité
Détection de fin de tour de parole
Savoir si un interlocuteur a fini de parler ou s'il marque simplement une pause, cherche un mot ou laisse sa phrase en suspens est un problème difficile en IA vocale. Un modèle dédié à la détection de fin de tour garantit que l'agent n'interrompt pas trop tôt et n'attend pas trop longtemps, pour un rythme de conversation naturel.
Gestion des hésitations et des interruptions
Tous les sons émis pendant un appel ne sont pas des interruptions. Un interlocuteur qui dit « euh » au milieu d'une phrase réfléchit, il ne cède pas la parole. Un modèle dédié distingue les hésitations des véritables interruptions afin que l'agent ne réagisse pas au moindre bruit.
Détection d'activité vocale
Le bruit de fond, la musique d'attente et les sons ambiants des centres de contact peuvent tous générer des faux positifs dans les systèmes de détection vocale basiques. Notre modèle VAD est entraîné à isoler la parole réelle de tout ce qui se passe par ailleurs sur un appel en direct, afin que l'agent se concentre sur ce que dit l'interlocuteur.
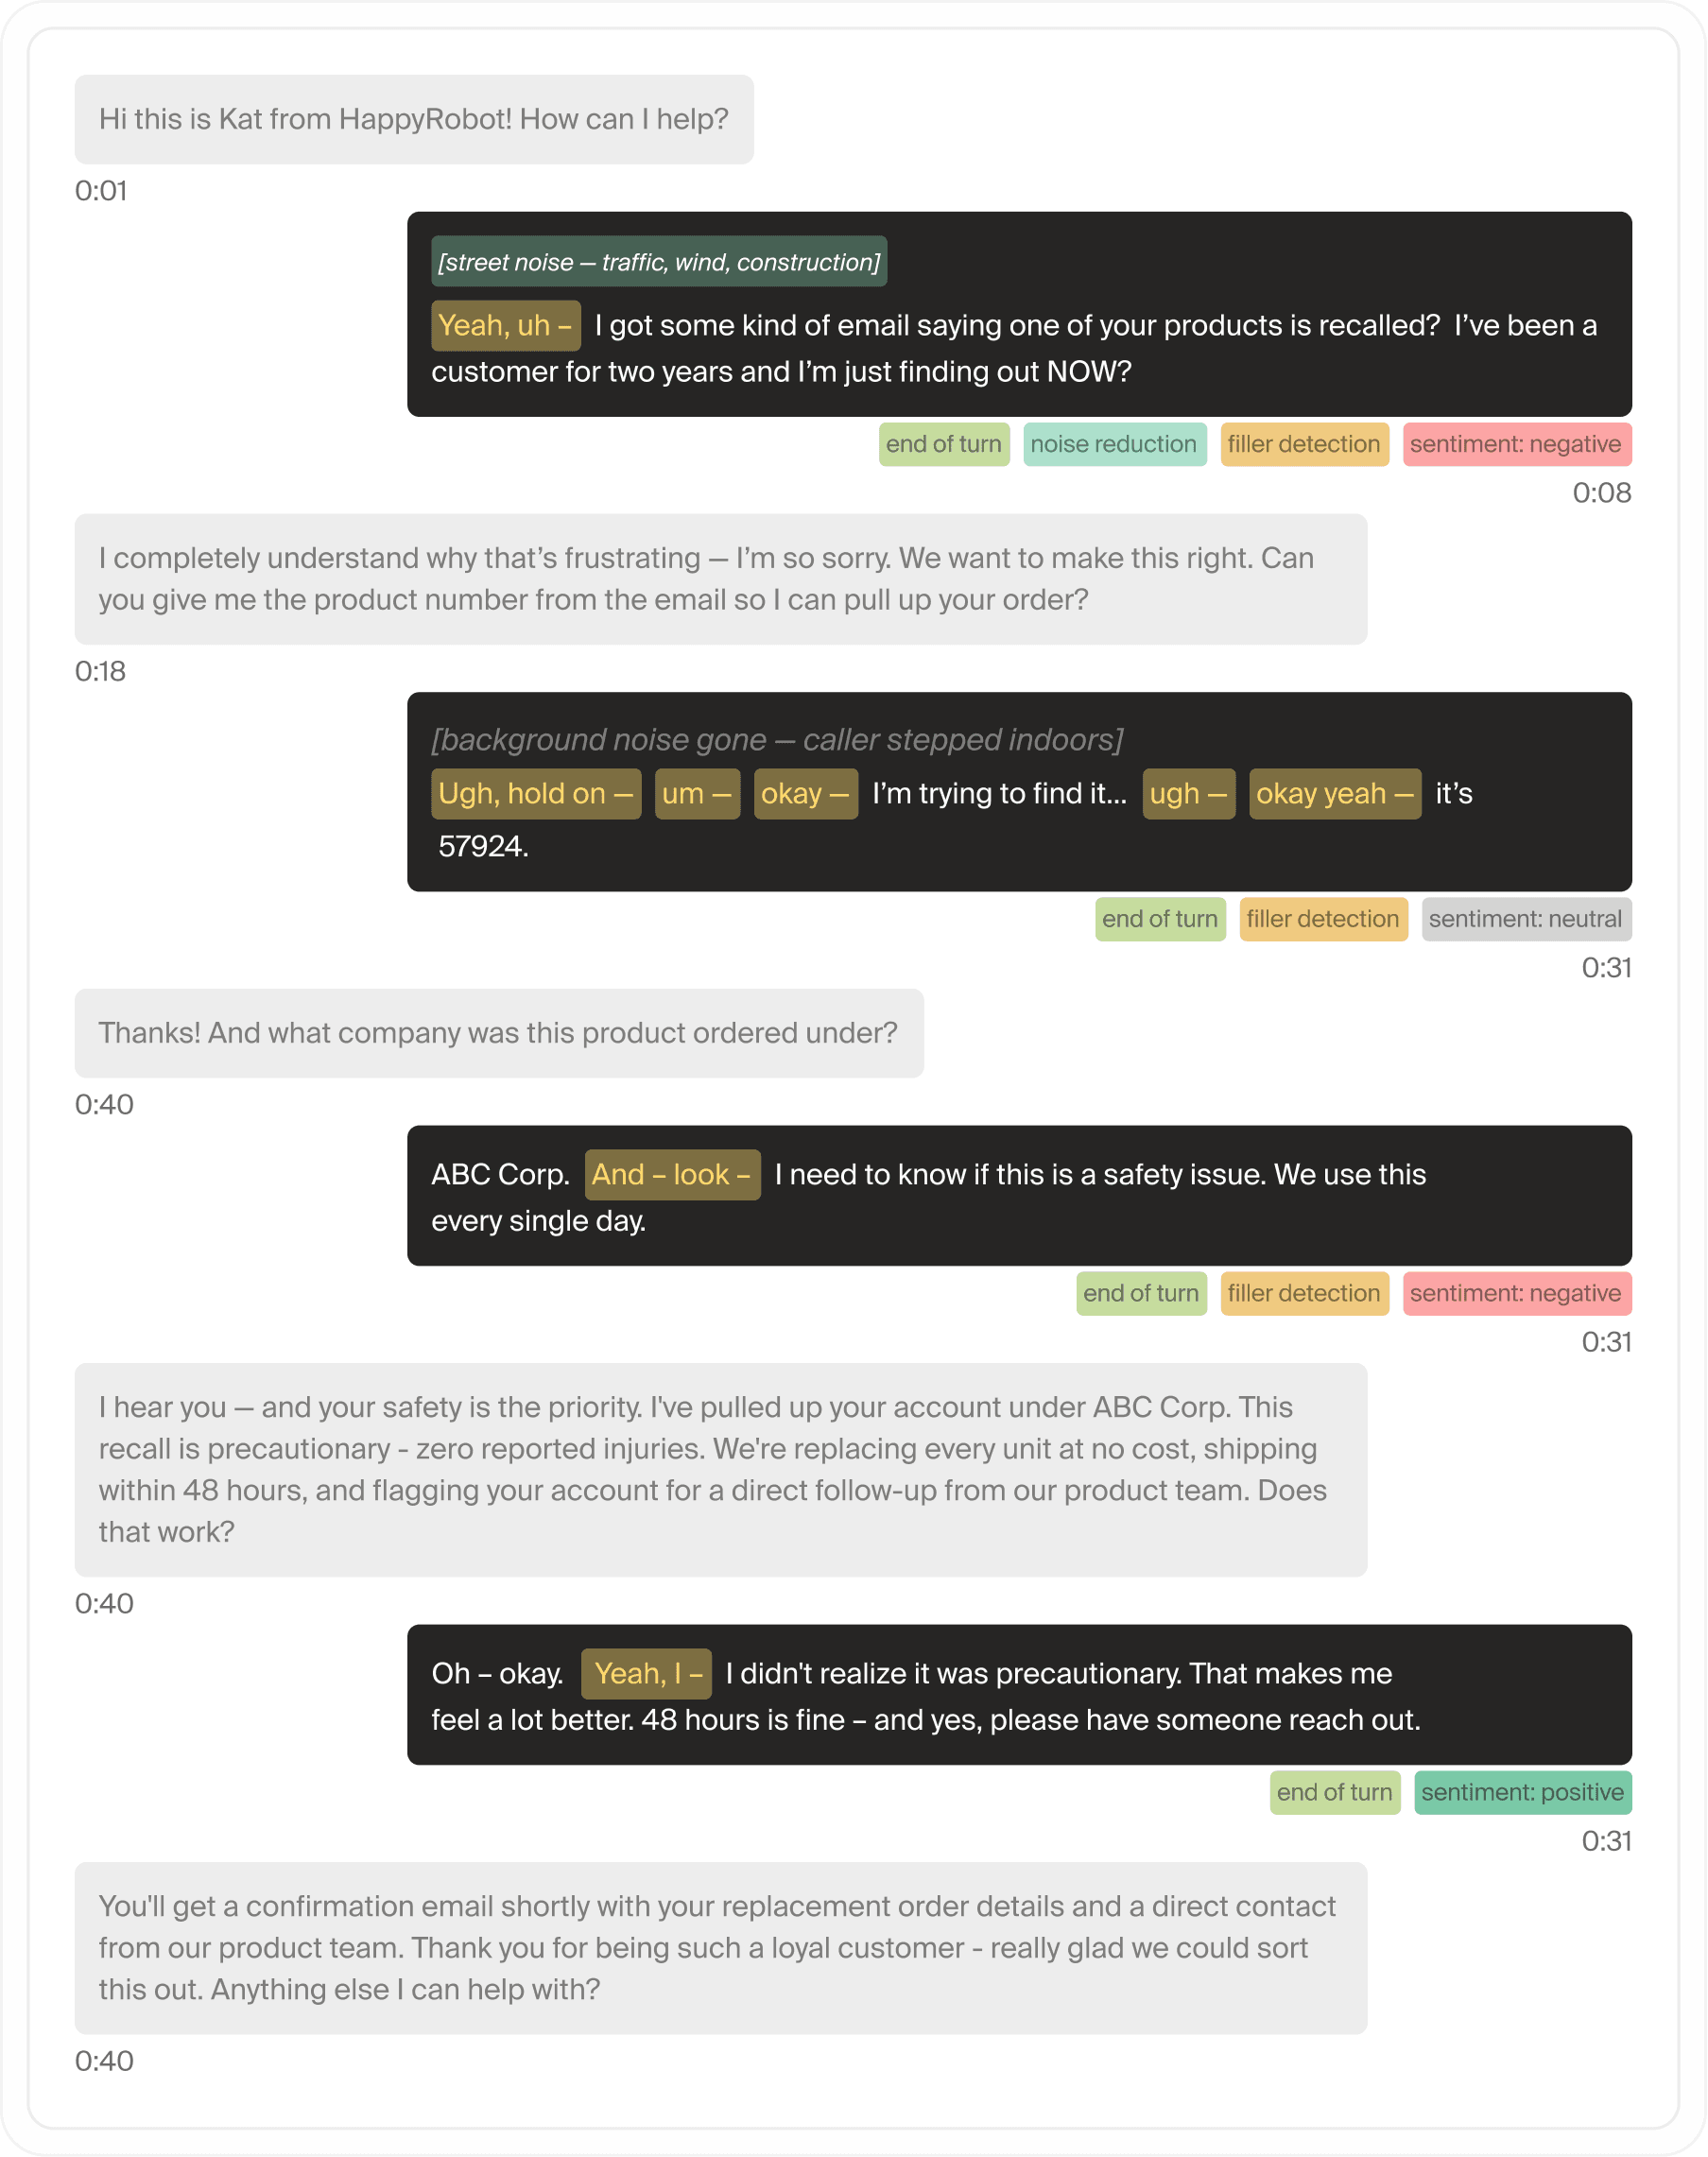
La précision sur les mots qui comptent le plus : tout ce que les modèles génériques écorchent
Transcription multi-fournisseurs avec basculement automatique
Des fournisseurs de transcription parallèles fonctionnent simultanément avec basculement automatique : si l'un se dégrade pour une raison quelconque, le pipeline change instantanément sans que l'interlocuteur s'en aperçoive ni que la conversation soit rompue.
Précision sur les nombres et les données de référence
Les modèles génériques confondent régulièrement les suites de chiffres contenues dans les numéros de commande, identifiants de suivi, numéros de téléphone et références de compte. Notre stack de transcription est spécifiquement optimisée pour la précision numérique dans des contextes d'entreprise où un seul chiffre mal entendu fait échouer une recherche en aval.
Renforcement de mots-clés
Les termes métier comme les codes produits, les noms de transporteurs ou le jargon sectoriel sont systématiquement mal traités par les modèles de transcription généralistes. Le renforcement de mots-clés prépare la couche de transcription au vocabulaire propre à votre activité, afin que les termes les plus importants pour vos workflows soient aussi les mieux captés.
Les interlocuteurs perçoivent la latence bien avant qu'elle n'apparaisse dans les métriques. Nous optimisons et mesurons chaque étape séparément : transcription, raisonnement, TTS, transit réseau, de sorte que toute dégradation soit immédiatement rattachée au composant qui en est la cause
Le son de la voix de l'agent, et pourquoi cela compte pour les appels
Un modèle de synthèse vocale (TTS) affiné pour le monde réel
La synthèse vocale en situation d'appel en direct n'a pas les mêmes exigences qu'un podcast ou une enceinte connectée. La prononciation des nombres, des dates, des abréviations et des termes métier doit être cohérente et correcte. Notre modèle TTS est affiné pour la diffusion téléphonique, et non adapté d'un produit généraliste de synthèse vocale.
Cohérence de voix entre fournisseurs
Lorsqu'un changement de fournisseur intervient en cours d'appel en raison d'un basculement ou d'un routage, les caractéristiques vocales sont préservées afin que l'interlocuteur ne perçoive aucun changement dans la voix de l'agent. La cohérence est maintenue au niveau du persona, pas seulement du texte.
Plus de 30 langues, avec une qualité vocale équivalente
La prise en charge multilingue ne se limite pas à la traduction. Chaque déploiement linguistique conserve la même qualité vocale, le même profil de latence et le même comportement du modèle conversationnel que la langue principale. Les interlocuteurs bénéficient de la même expérience dans toutes les langues prises en charge, et non d'une solution de repli dégradée.