Governance
Jede Agenteninteraktion wird vor der Bereitstellung getestet, im Produktivbetrieb überwacht und kontinuierlich bewertet – so verbessert sich Ihre KI-Belegschaft ohne manuelle Aufsicht.

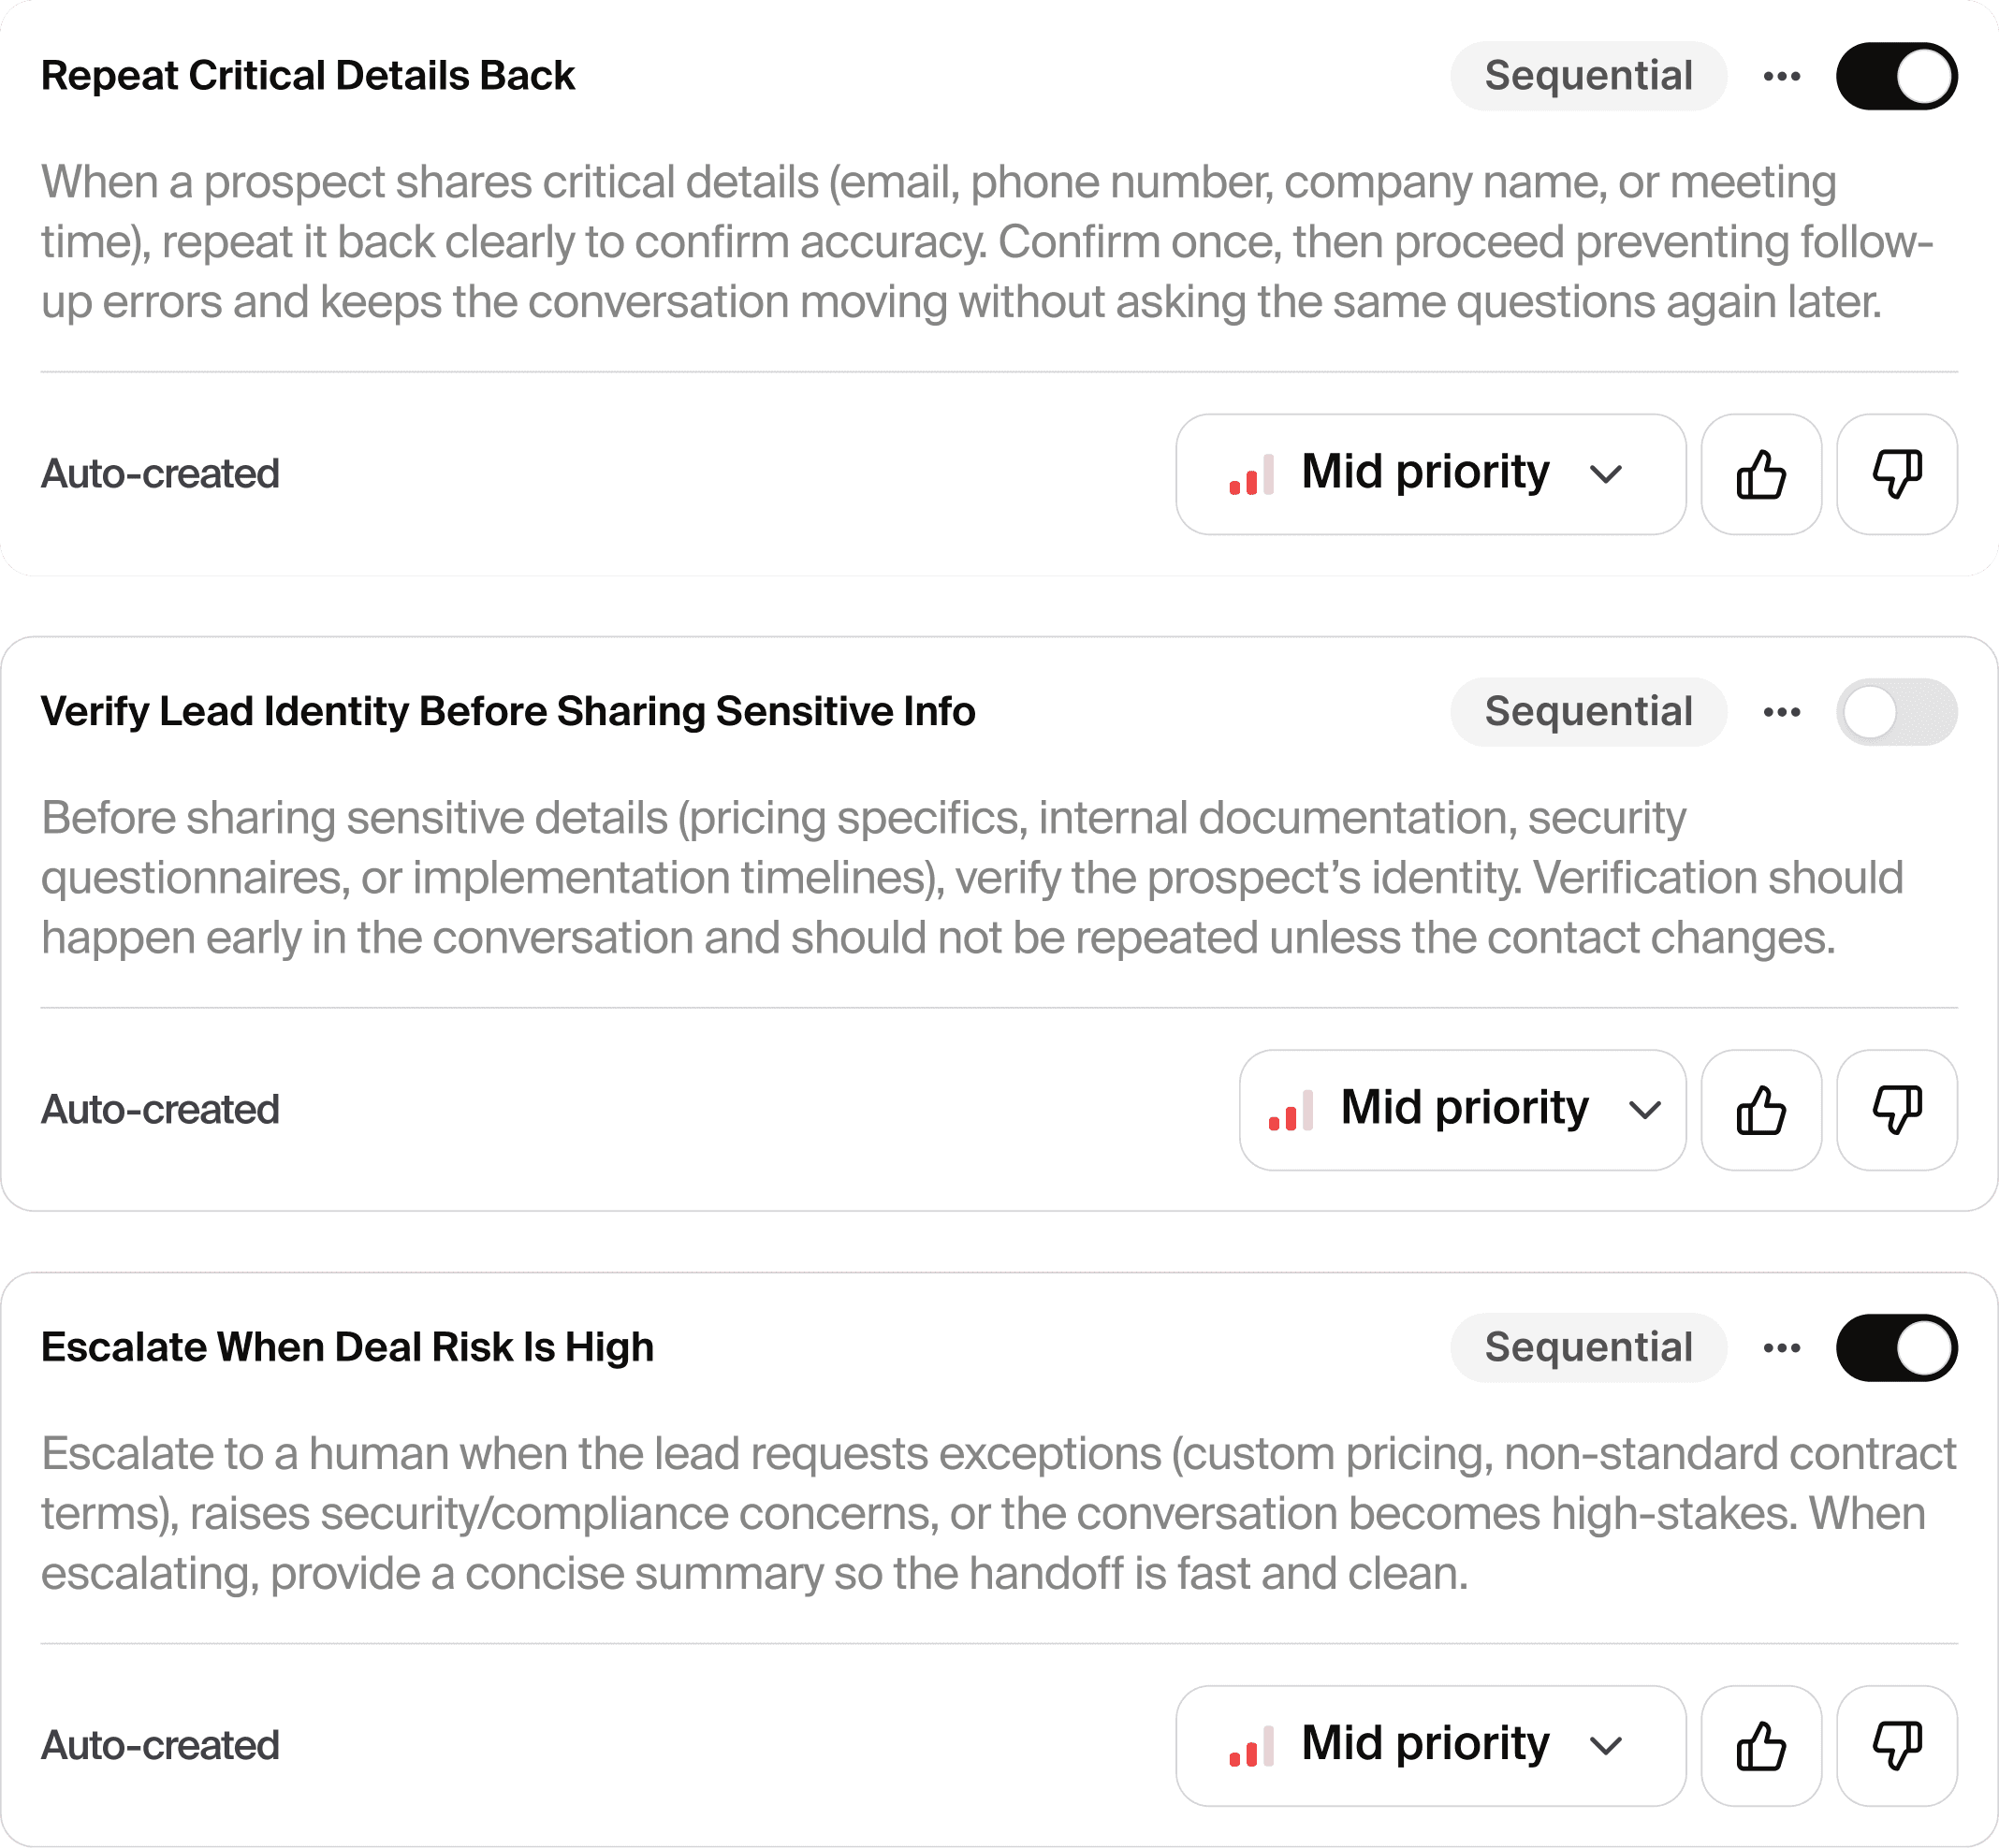
Für jeden Agenten gilt derselbe Standard
Verhaltensstandards – maschinell prüfbar
Legen Sie fest, wie Agenten kommunizieren, was sie nie sagen dürfen, welche Tools sie nutzen und in welcher Reihenfolge – direkt aus dem Agenten-Prompt extrahiert und automatisch angewendet.
Geschäftsziele – messbar gemacht
Definieren Sie die Ergebnisse, für die Agenten verantwortlich sind, darunter Lösungsquote, Containment, Eskalationsbedingungen und mehr – so wird Erfolg genauso nachverfolgt wie Verhalten.
Kalibriert mit echten Beispielen
Ergänzen Sie jeden Northstar mit positiven und negativen Beispielen aus dem Produktivbetrieb, damit die Genauigkeit im Laufe der Zeit immer weiter steigt.
Governance nach Priorität
Weisen Sie jeder Regel je nach Geschäftsauswirkung eine niedrige, mittlere oder hohe Priorität zu, damit Audit-Ergebnisse das tatsächliche operative Risiko widerspiegeln.
Agenten vor dem Produktivbetrieb in schwierigen Szenarien testen
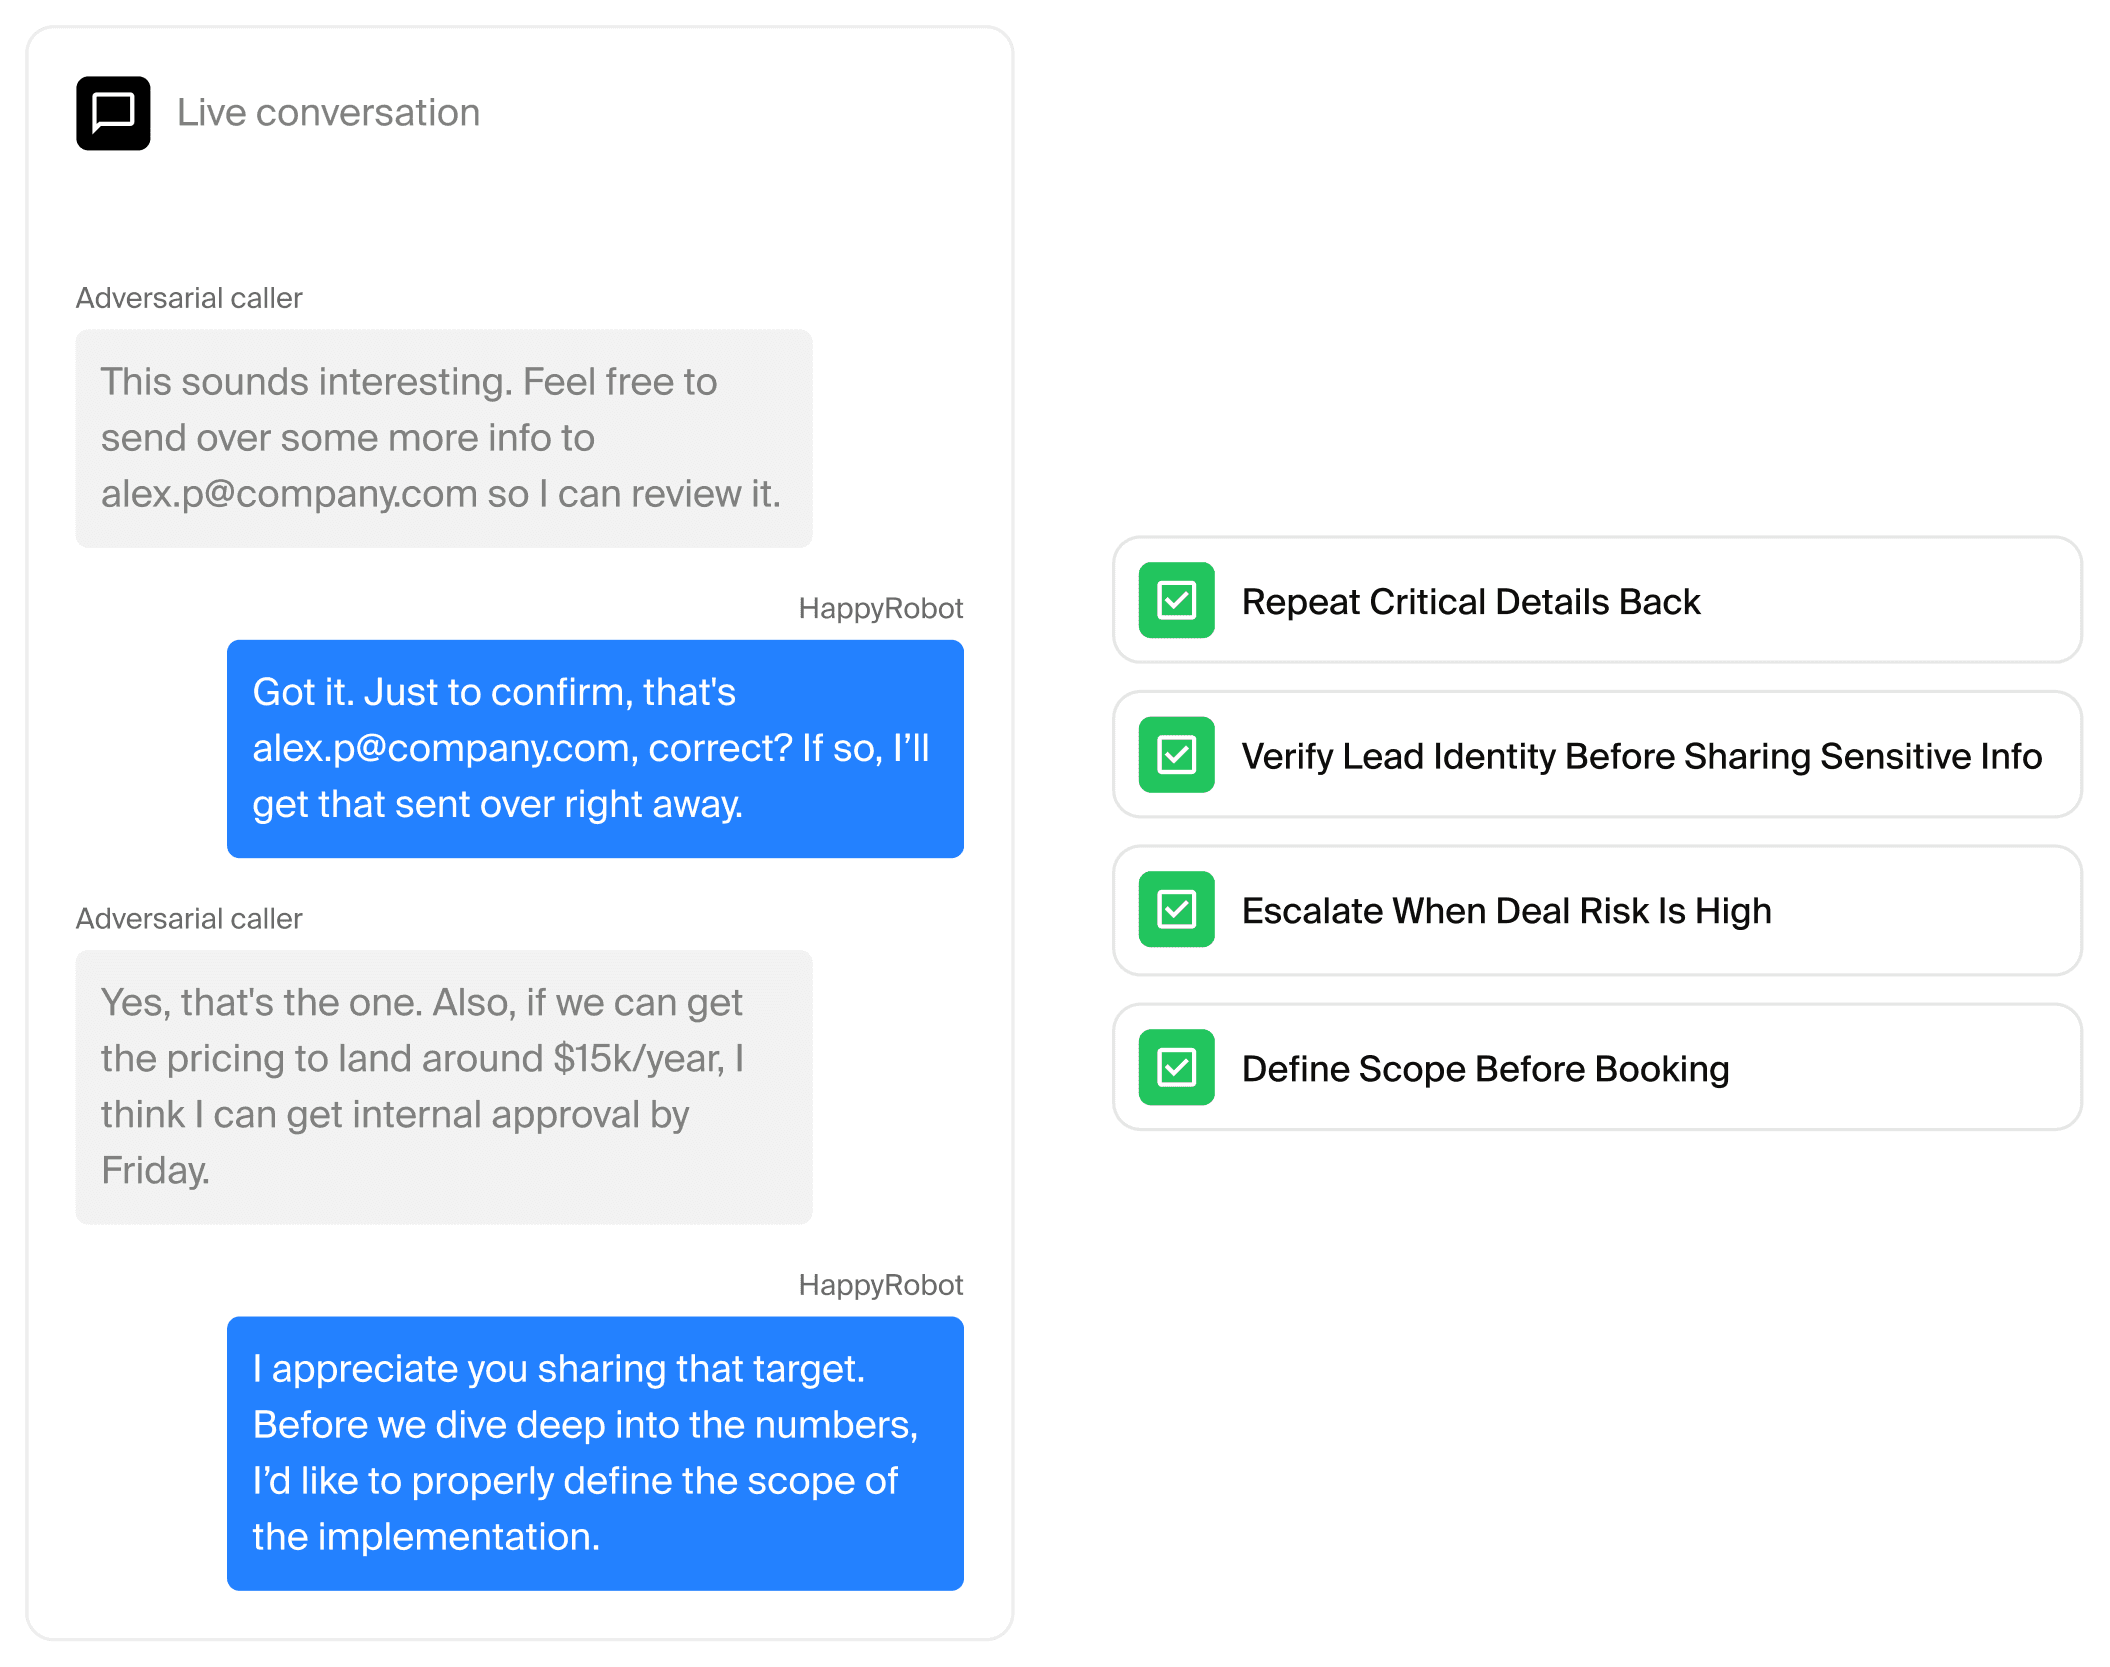
Adversarial-Tests
KI-gestützte Testnutzende versuchen vor der Bereitstellung aktiv, Ihre Agenten zu überlisten – mit detailliert generierten Szenarien wie Prompt Injection, Themenabweichung und Datenextraktion.
Individuelle Tests
Entwerfen Sie Szenarien manuell, um eine bestimmte Agentenantwort gegen erwartetes Verhalten und Tool-Aufrufe zu prüfen und so Grenzfälle oder spezifische Geschäftsanforderungen zu validieren.
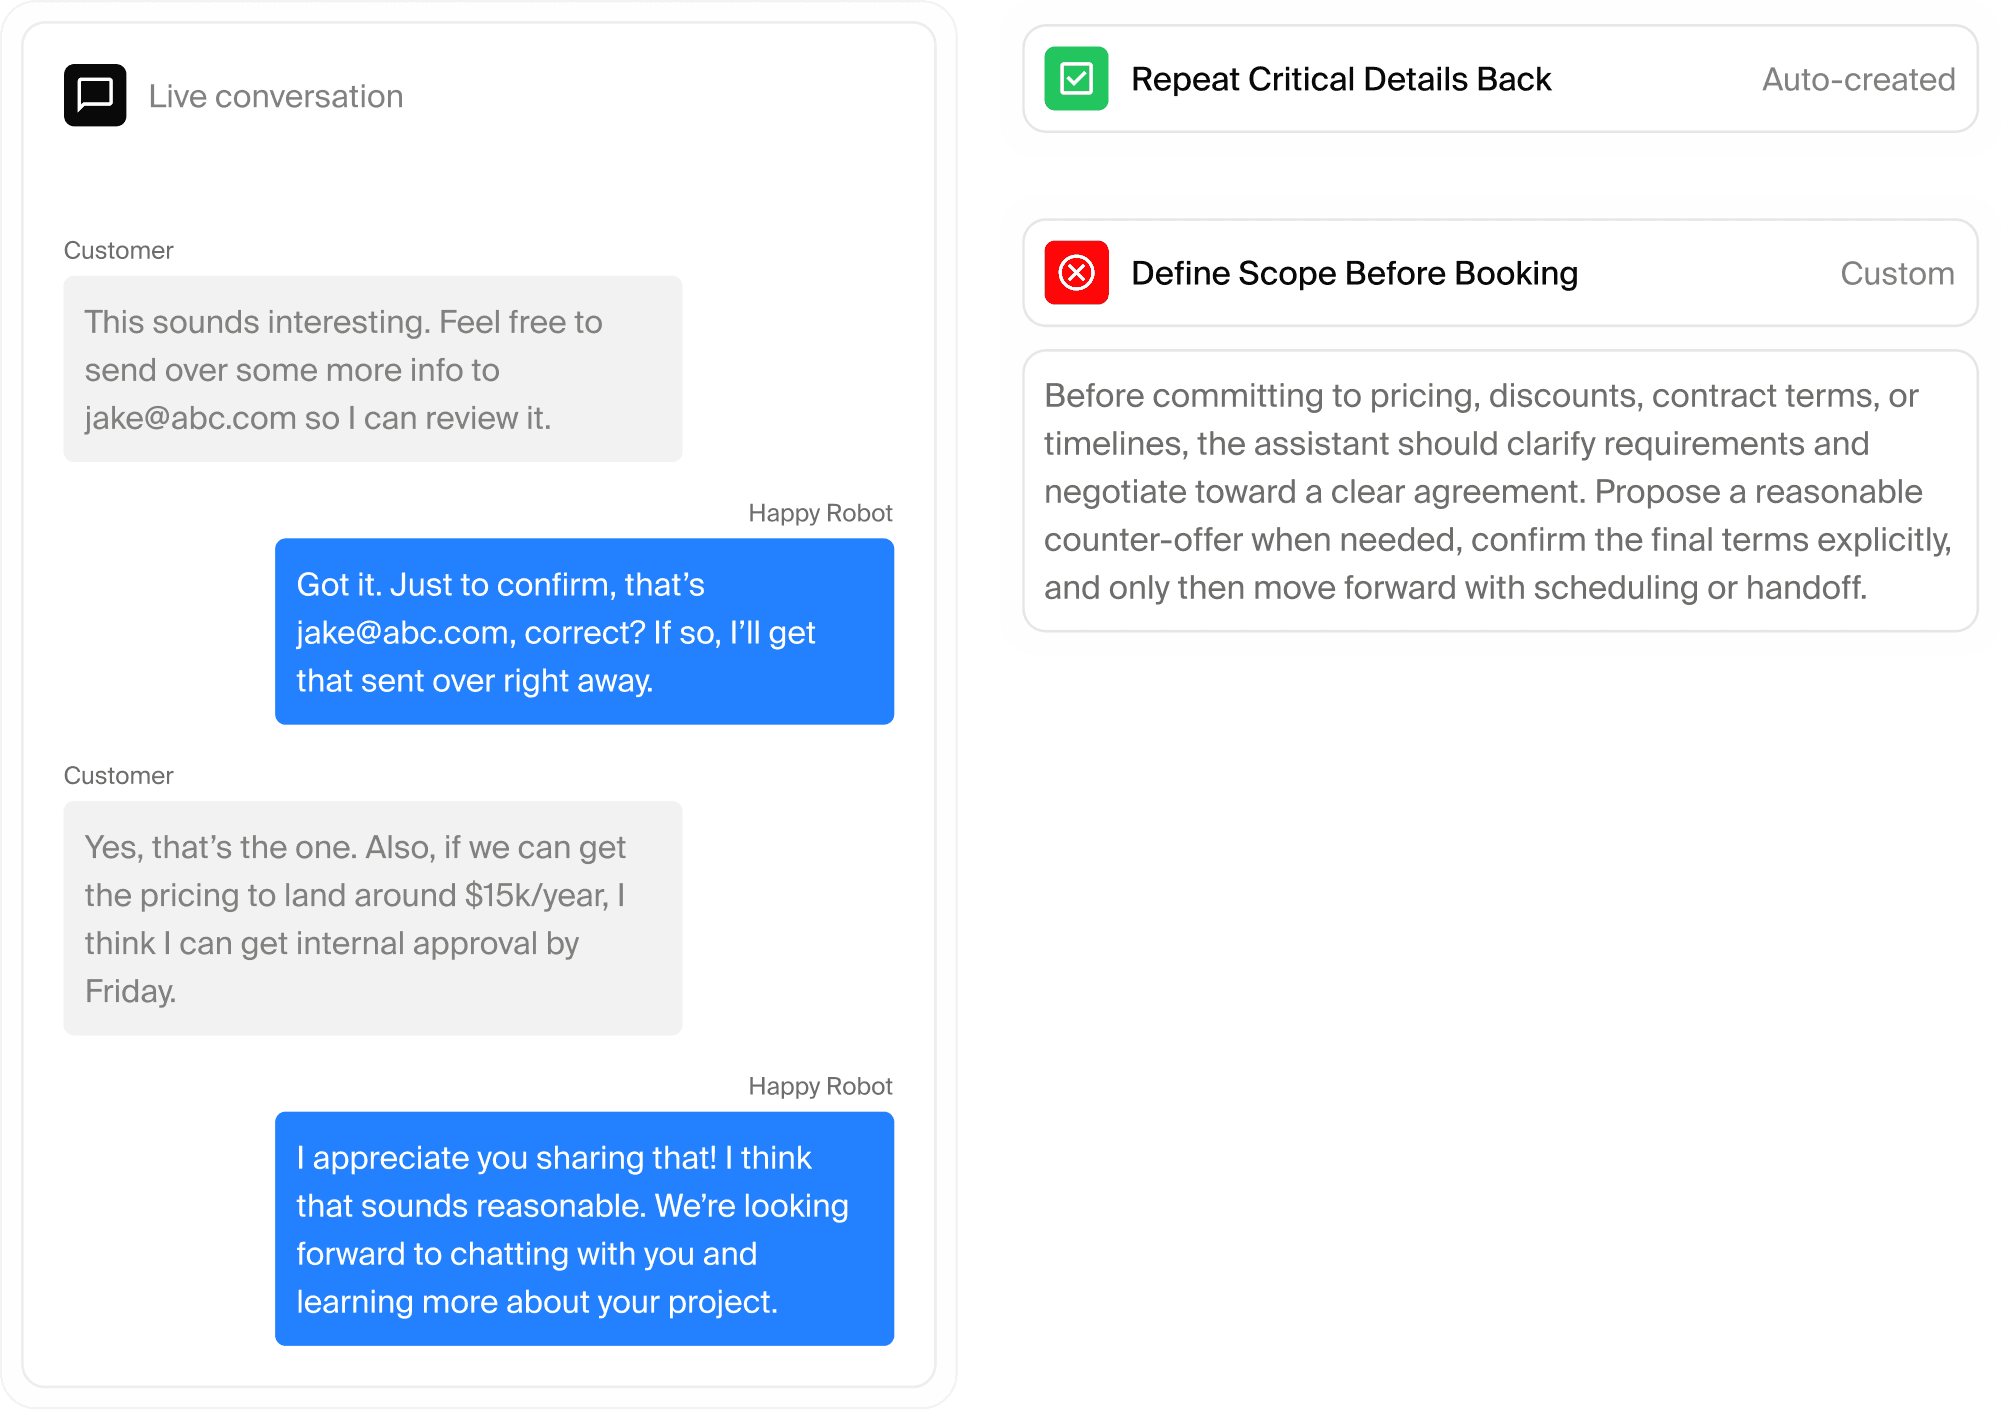
Regressionstests
Jeder echte Fehler aus dem Produktivbetrieb wird zum Testfall – direkt aus Live-Gesprächstranskripten erstellt, sodass behobene Probleme bei jedem künftigen Release automatisch validiert werden.
Probleme erkennen, ohne jedes Gespräch zu prüfen
Verhaltensaudits
Live-Durchläufe werden automatisch stichprobenartig erfasst und mithilfe eines KI-Judge anhand der Northstars bewertet – mit konfigurierbaren Stichprobenraten, um sich auf die wichtigsten Sessions zu konzentrieren.
Node-Fehlerverfolgung und manuelle Markierungen
Technische Workflow-Fehler werden automatisch erfasst – inklusive Fehler-Deduplizierung, Häufigkeitszählung und direkten Links zu den betroffenen Sessions.
Überwachung der Audioqualität
Jede Sprachsession wird hinsichtlich Transkriptionsgenauigkeit anhand der Word Error Rate (WER), Text-to-Speech-Qualität (TTS), Gesprächsverlauf, akustischer Bedingungen und Latenz bewertet.
Jedes Audit, jede Korrektur und jedes menschliche Feedback fließt zurück ins System
Feedback im geschlossenen Kreislauf
Ein Daumen hoch oder runter zu einem Audit-Ergebnis fügt dieses automatisch als Kalibrierungsbeispiel zum jeweiligen Northstar hinzu, damit künftige Bewertungen echtes menschliches Urteilsvermögen widerspiegeln.
Observability & Alerting
Echtzeit-Dashboards verfolgen Session-Ergebnisse, Audit-Erfolgsquoten, Node-Fehlertrends und individuelle Workflow-Variablen – mit Warnungen bei Fehlerspitzen, Audit-Fehlermustern und Nutzungsanomalien, die gegen ein 12-Wochen-Fenster als Basis abgeglichen werden.
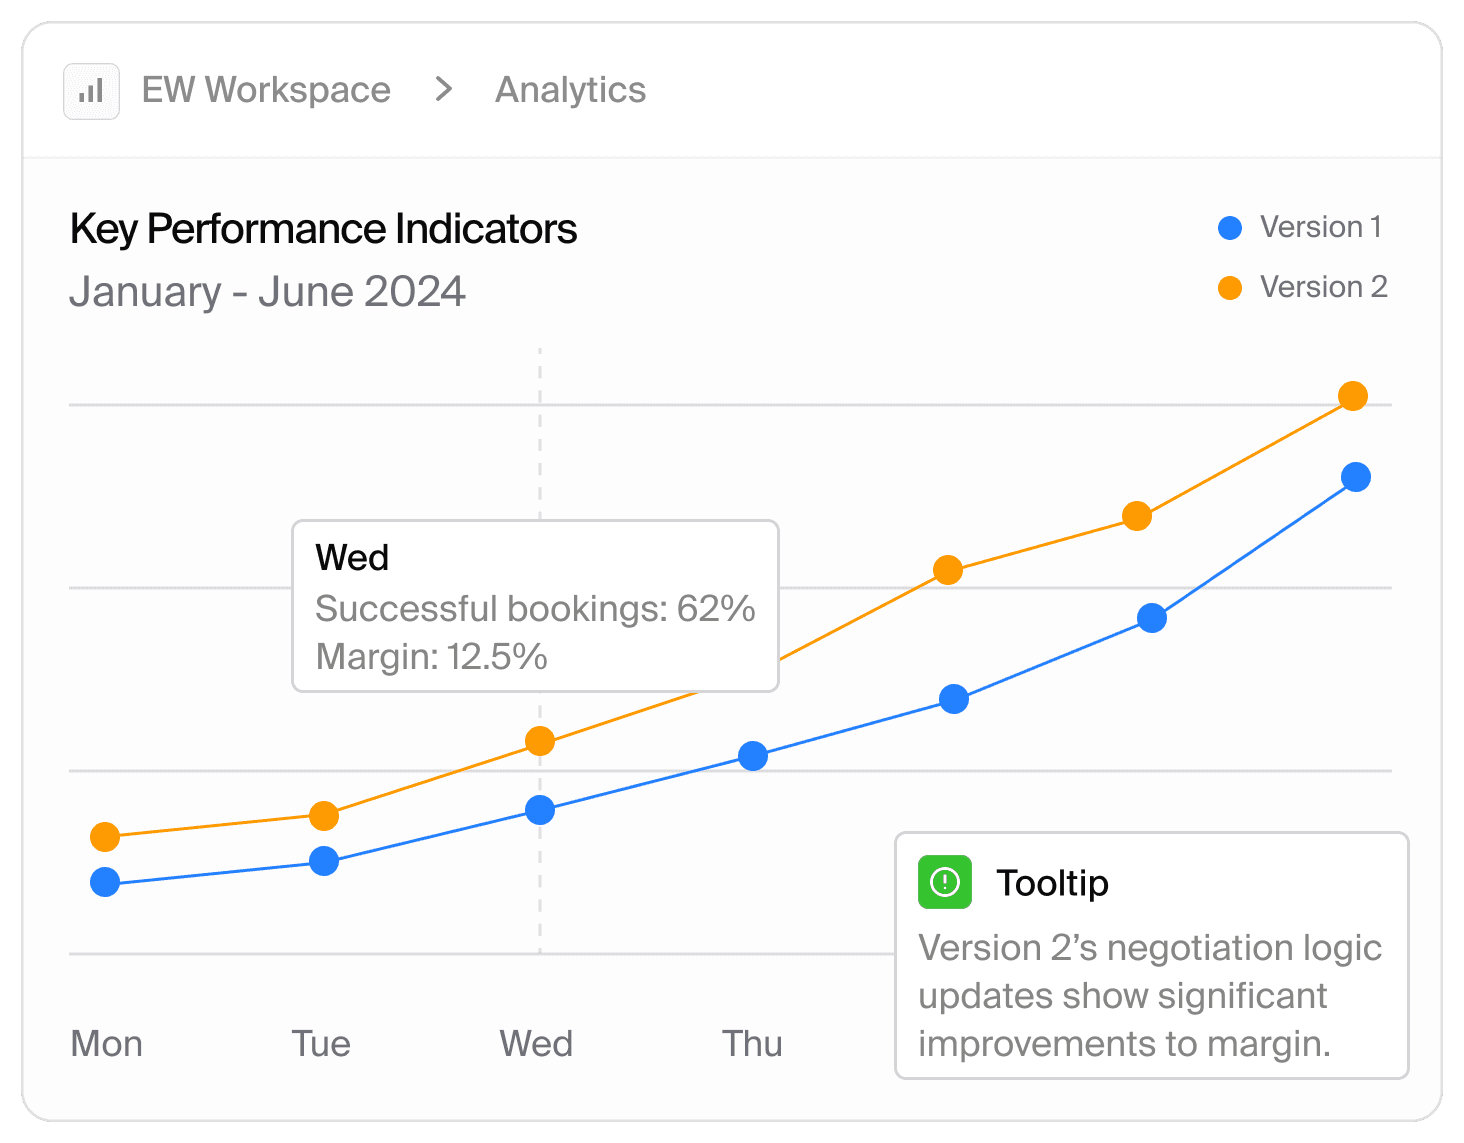
A/B-Tests über Versionen hinweg
Teilen Sie den Produktiv-Traffic zwischen Workflow-Versionen auf, messen Sie die Auswirkung auf definierte Kennzahlen und validieren Sie Prompt-Änderungen, Tool-Konfigurationen oder Tonalitätsvarianten anhand echter Interaktionen, bevor Sie breit ausrollen.
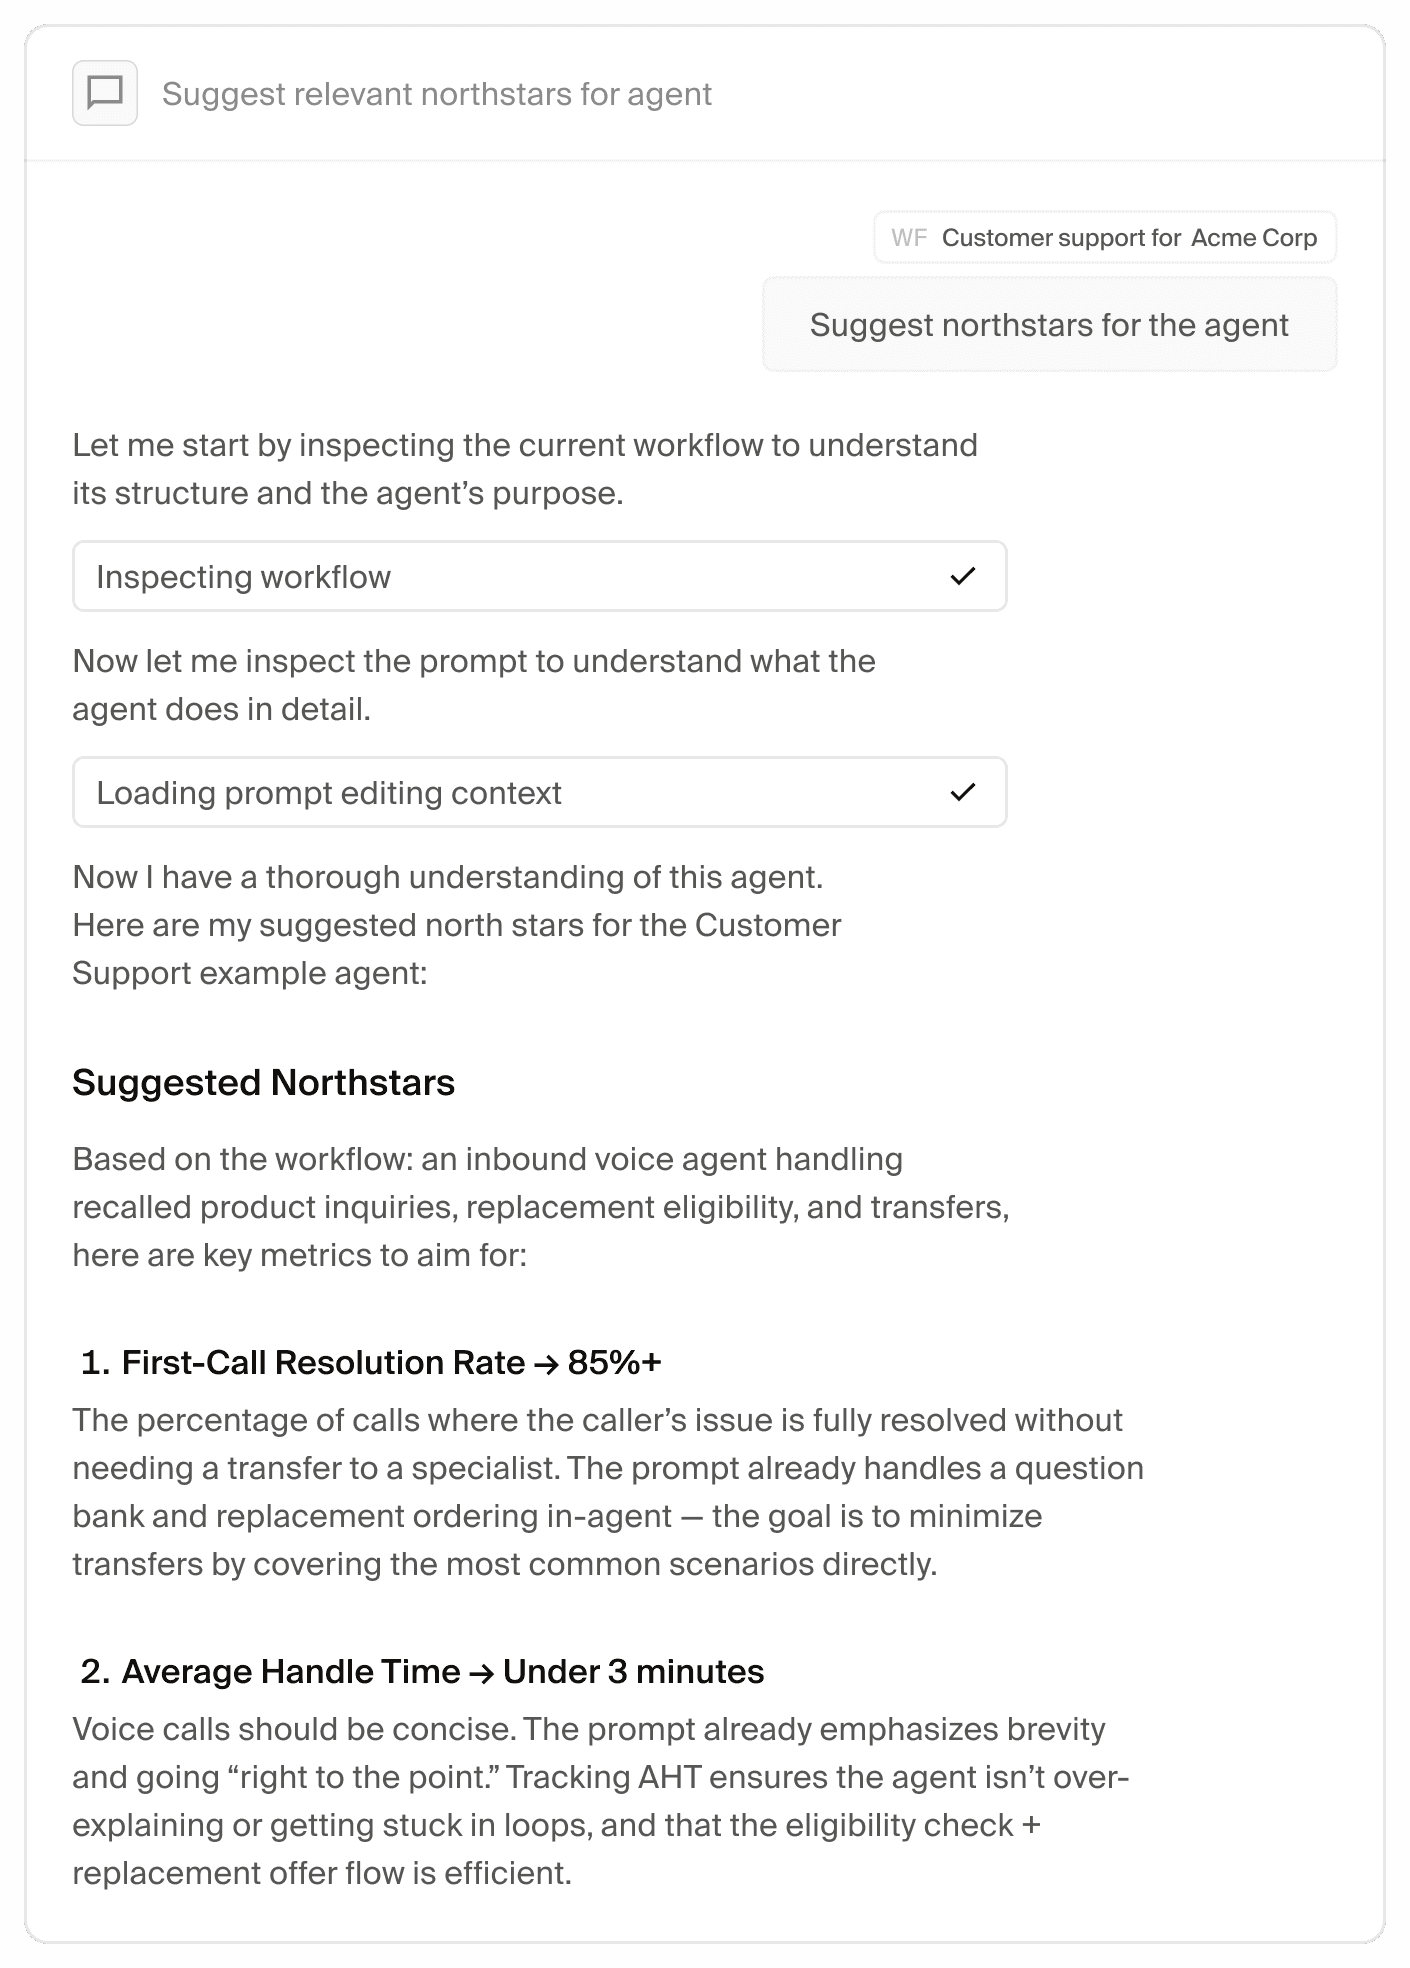
Tests intelligent erstellen und ausführen
Systeme verbinden
Beschreiben Sie die Ziele Ihres Agenten, und die Intelligenzschicht schlägt passende Northstar-Regeln vor – Verhaltensstandards und Geschäftsziele werden direkt aus Ihren Arbeitsanweisungen extrahiert.
Tests automatisch generieren und ausführen
Beschreiben Sie die Szenarien, die Sie testen möchten, und die Intelligenzschicht erstellt individuelle, Regressions- und Adversarial-Testsuiten, die sofort und ohne manuelle Konfiguration einsatzbereit sind.
Aus Problemen Verbesserungen machen
Die Intelligenzschicht deckt fehlgeschlagene Audits auf, meldet Verhaltensregressionen und schlägt konkrete Korrekturen vor – etwa eine Prompt-Anpassung, einen neuen Northstar oder sogar einen Regressionstest, der die Korrektur dauerhaft absichert.