Proprietärer Voice-Stack für Gespräche auf menschlichem Niveau
Eine speziell entwickelte Voice-Pipeline für die Unwägbarkeiten echter Unternehmensanrufe
Warum sich die Voice AI von HappyRobot unterscheidet
Unsere TTS
Die meisten Voice AI-Systeme sind für kontrollierte Bedingungen gebaut. Unternehmenstelefonie ist nicht kontrolliert – Anrufende haben Akzente, es gibt Hintergrundgeräusche, fachspezifische Terminologie und keine Geduld für roboterhafte Antworten oder unangenehme Pausen. Die Voice-Pipeline von HappyRobot ist ein Stack aus 10 Modellen, bei dem jede Komponente speziell für Live-Telefonie in großem Umfang feinabgestimmt ist – und nicht von einem allgemeinen Consumer-Produkt abgeleitet wurde.
Das Hin und Her eines echten Gesprächs, ohne den Fluss zu unterbrechen
Erkennung des Sprecherwechsels
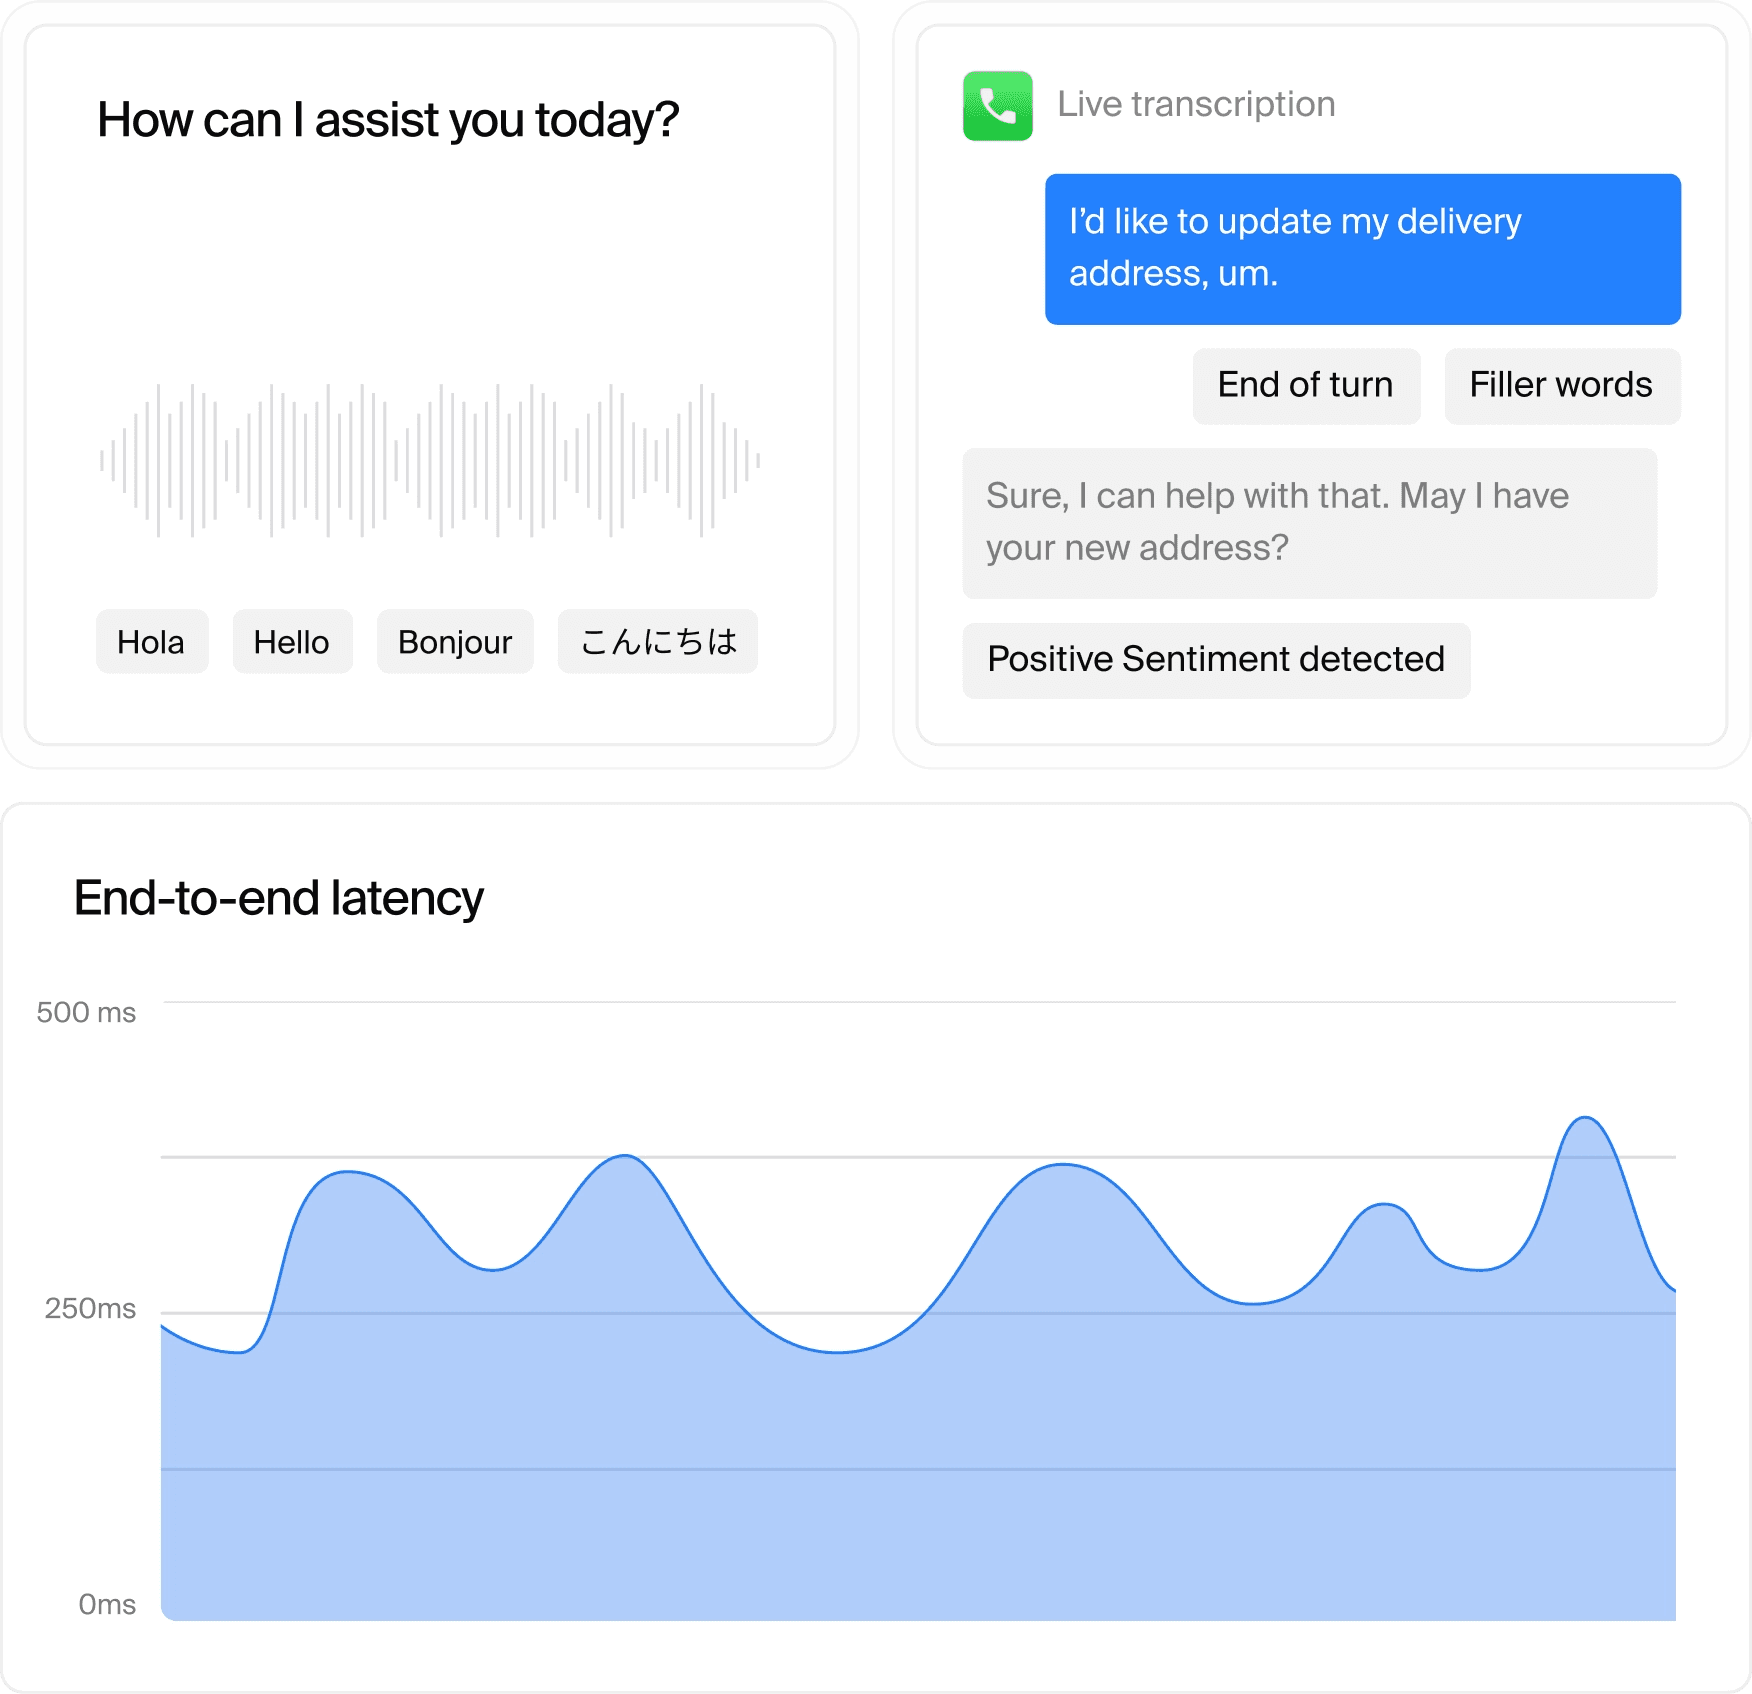
Zu erkennen, ob Anrufende zu Ende gesprochen haben oder nur mitten im Gedanken innehalten, nach einem Wort suchen oder ausklingen, ist eine schwierige Aufgabe in der Voice AI. Ein eigenes Modell zur Erkennung des Sprecherwechsels sorgt dafür, dass der agent weder zu früh einsetzt noch zu lange wartet – für einen natürlichen Gesprächsrhythmus.
Umgang mit Füllwörtern und Unterbrechungen
Nicht jedes Geräusch im Gespräch ist eine Unterbrechung. Wer mitten im Satz „ähm“ oder „äh“ sagt, denkt nach und gibt nicht das Wort ab. Ein eigenes Modell unterscheidet Füllwörter von echten Unterbrechungen, sodass der agent nicht auf jedes Geräusch reagiert.
Sprachaktivitätserkennung
Hintergrundgeräusche, Wartemusik und Umgebungsgeräusche in Contact Center-Umgebungen können in einfachen Spracherkennungssystemen Fehlalarme auslösen. Unser VAD-Modell ist darauf trainiert, tatsächliche Sprache von allem anderen zu trennen, was während eines Live-Anrufs passiert – damit der agent sich auf das konzentriert, was Anrufende sagen.
Genauigkeit bei den wichtigsten Wörtern – bei allem, was generische Modelle verstümmeln
Transkription über mehrere Anbieter mit automatischem Failover
Parallele Transkriptionsanbieter laufen gleichzeitig mit automatischem Failover – verschlechtert sich einer aus irgendeinem Grund, wechselt die Pipeline sofort, ohne dass Anrufende es bemerken oder das Gespräch abbricht.
Genauigkeit bei Zahlen und Referenzdaten
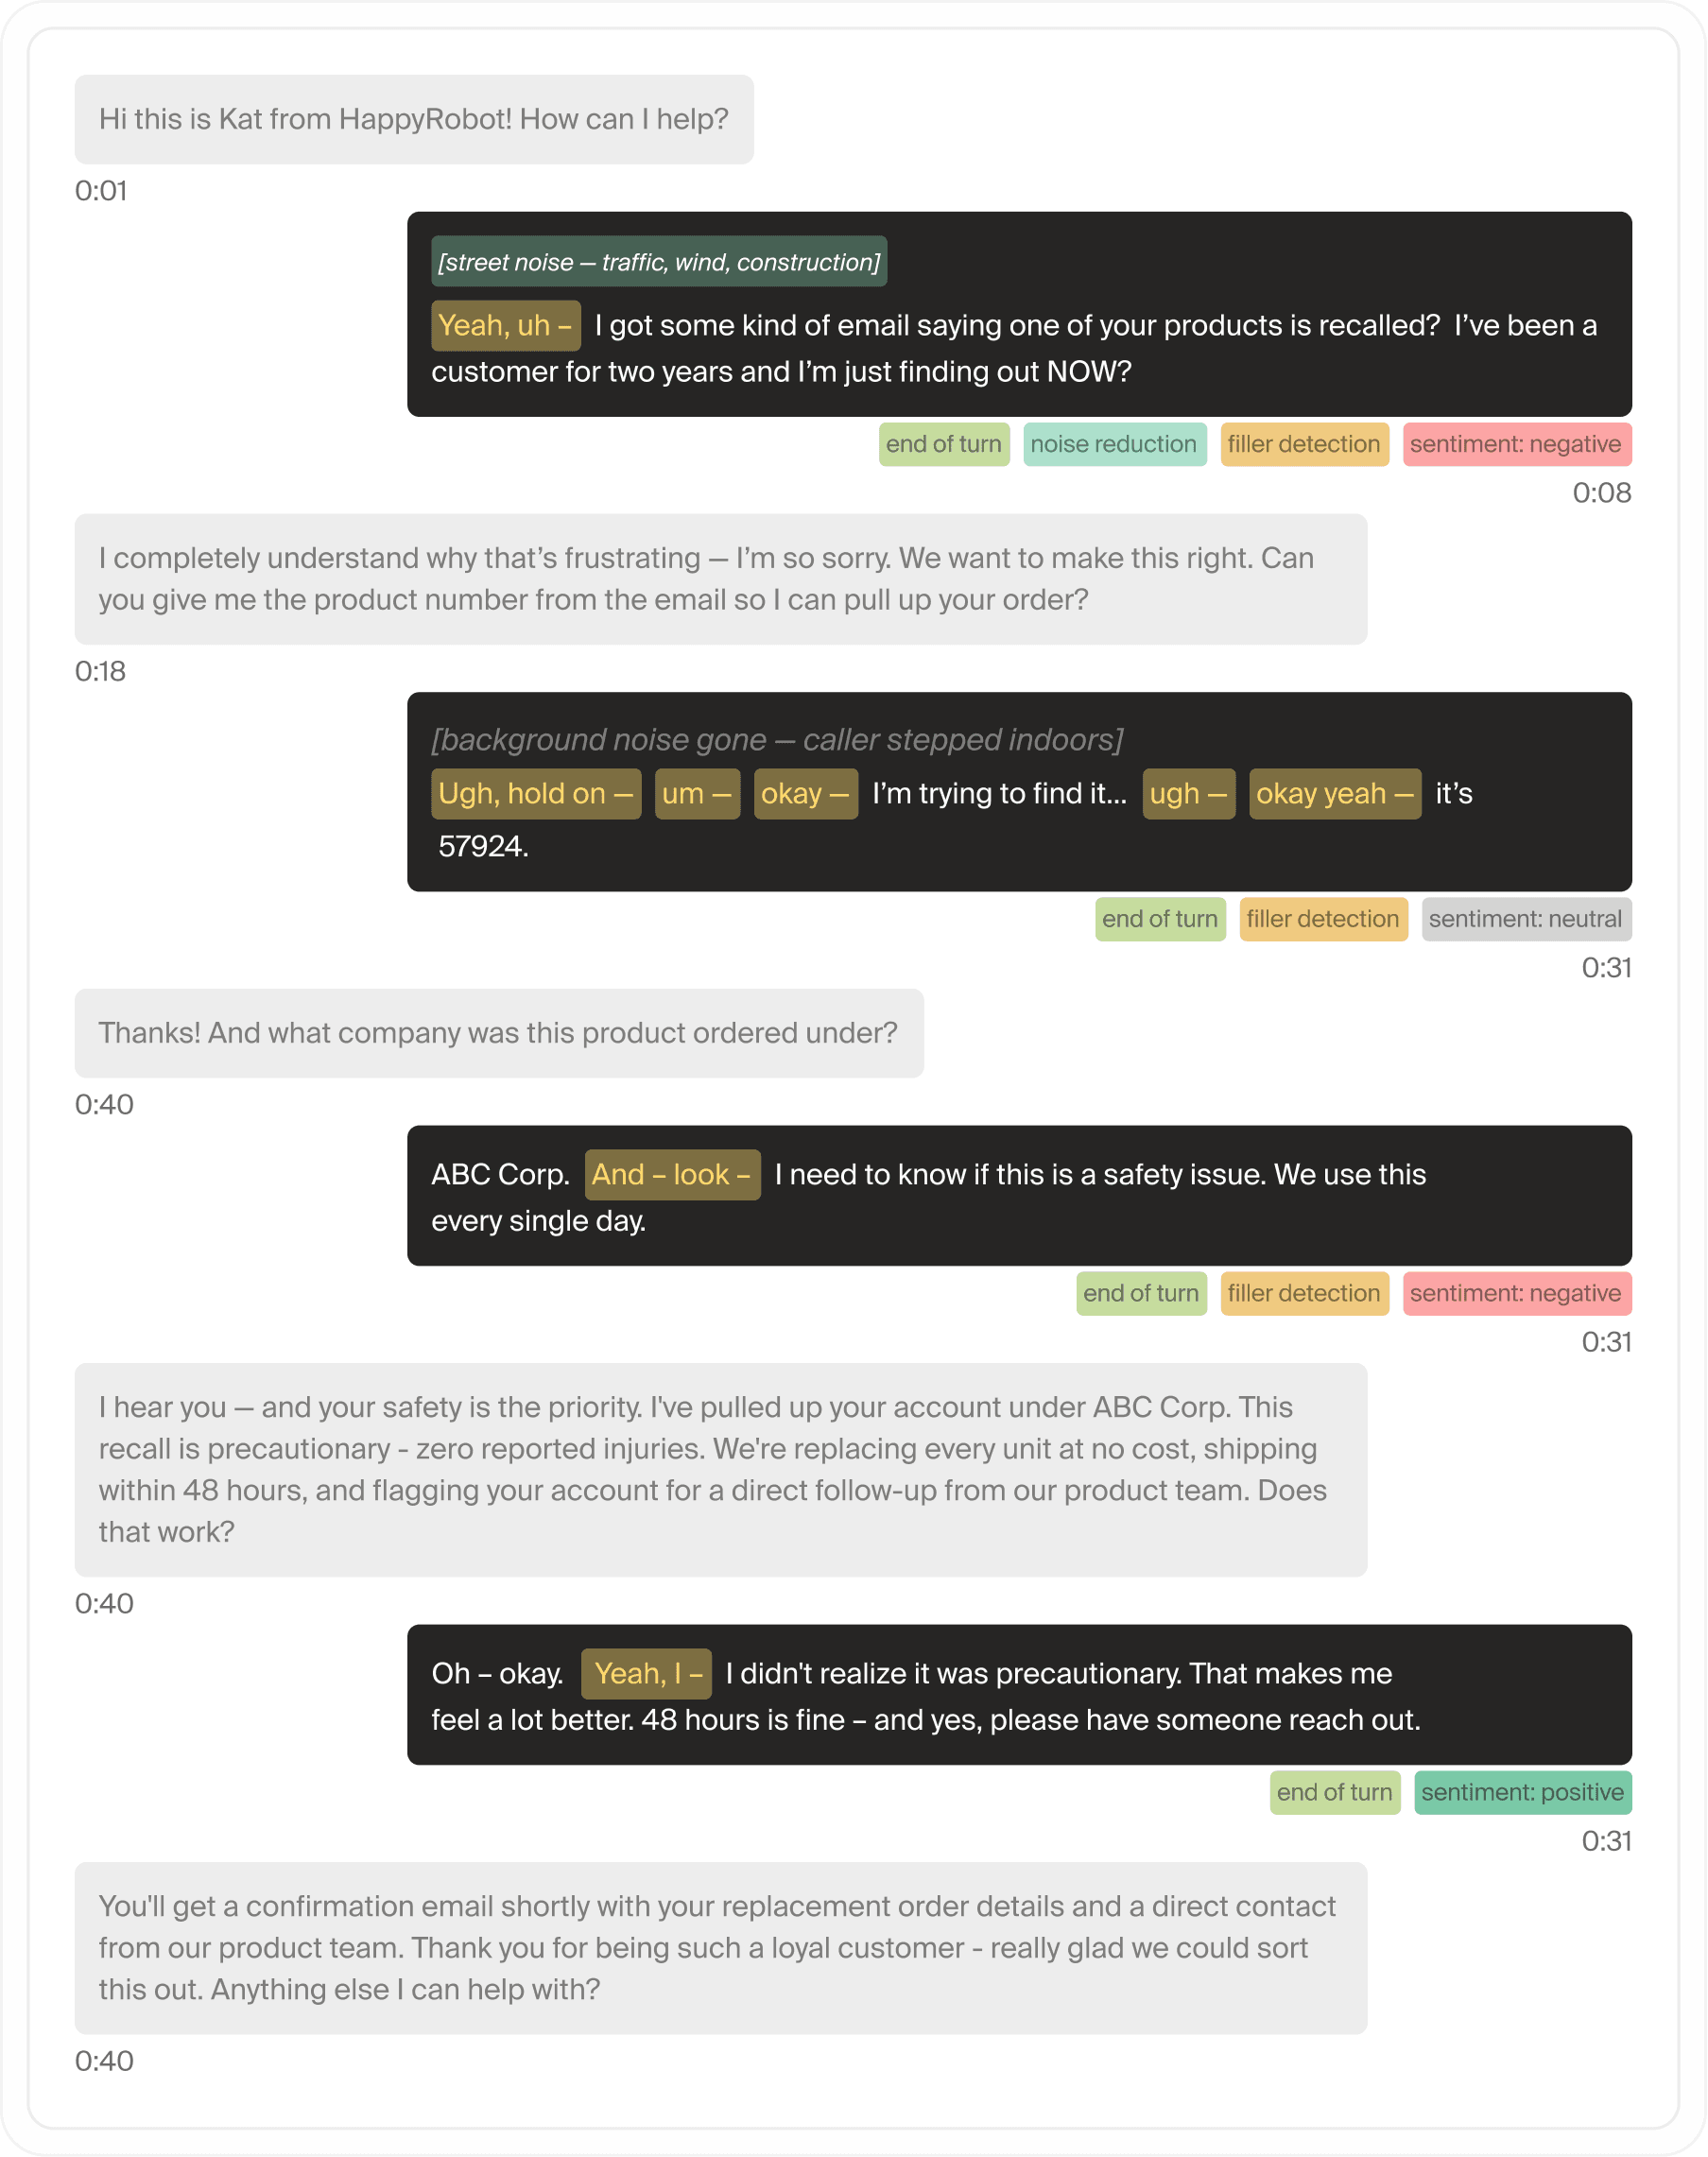
Generische Modelle verhören sich regelmäßig bei Ziffernfolgen in Bestellnummern, Tracking-IDs, Telefonnummern oder Kontoreferenzen. Der Transkriptions-Stack ist gezielt auf numerische Genauigkeit in Unternehmenskontexten abgestimmt, in denen eine einzige falsch verstandene Ziffer eine nachgelagerte Abfrage unbrauchbar macht.
Keyword-Boosting
Fachspezifische Begriffe wie Produktcodes, Namen von Frachtführern oder Branchenjargon werden von allgemeinen Transkriptionsmodellen systematisch schlecht erkannt. Keyword-Boosting bereitet die Transkriptionsschicht auf das spezifische Vokabular Ihres Betriebs vor, sodass genau die Begriffe, die für Ihre workflows entscheidend sind, am genauesten erfasst werden.
Anrufende spüren Latenz lange bevor sie als Kennzahl sichtbar wird. Wir optimieren und messen jede Stufe separat – Transkription, Reasoning, TTS, Netzwerkübertragung – sodass jede Verschlechterung sofort auf die verursachende Komponente zurückzuführen ist
Wie der agent klingt – und warum das für Anrufe entscheidend ist
Feinabgestimmte Text-to-Speech (TTS) für die Praxis
Text-to-Speech in einer Live-Anrufumgebung stellt andere Anforderungen als ein Podcast oder ein Smart Speaker. Die Aussprache von Zahlen, Daten, Abkürzungen und Fachbegriffen muss konsistent und korrekt sein. Unser TTS-Modell ist für die Telefonie feinabgestimmt und nicht von einem allgemeinen Sprachsynthese-Produkt abgeleitet.
Stimmabgleich über Anbieter hinweg
Wenn mitten im Gespräch durch Failover oder Routing ein Anbieterwechsel erfolgt, bleiben die Stimmmerkmale erhalten, sodass Anrufende keine Veränderung im Klang des agent bemerken. Konsistenz wird auf Persona-Ebene gewahrt, nicht nur auf Textebene.
Über 30 Sprachen mit gleichbleibender Sprachqualität
Mehrsprachigkeit ist mehr als nur Übersetzung. Jede Sprachbereitstellung bietet dieselbe Sprachqualität, dasselbe Latenzprofil und dasselbe Verhalten des Konversationsmodells wie die Primärsprache. Anrufende erhalten in jeder unterstützten Sprache dasselbe Erlebnis – keine abgespeckte Notlösung.