Données agentiques
Chaque interaction traitée par vos agents génère des données. Voici comment elles sont capturées, structurées et exploitées.
Qu'est-ce que les données agentiques ?
Chaque interaction traitée par vos agents génère des données que les collaborateurs humains n'ont jamais produites : non seulement ce qui a été dit, mais aussi ce qui a été consulté, ce qui a été décidé et ce qui s'est passé à chaque étape de l'exécution. Les données agentiques transforment ces actions des agents en informations structurées et interrogeables, définies et écrites automatiquement pendant l'exécution, sans post-traitement ni revue manuelle.
Des données structurées et connectées dès l'extraction
Variables personnalisées
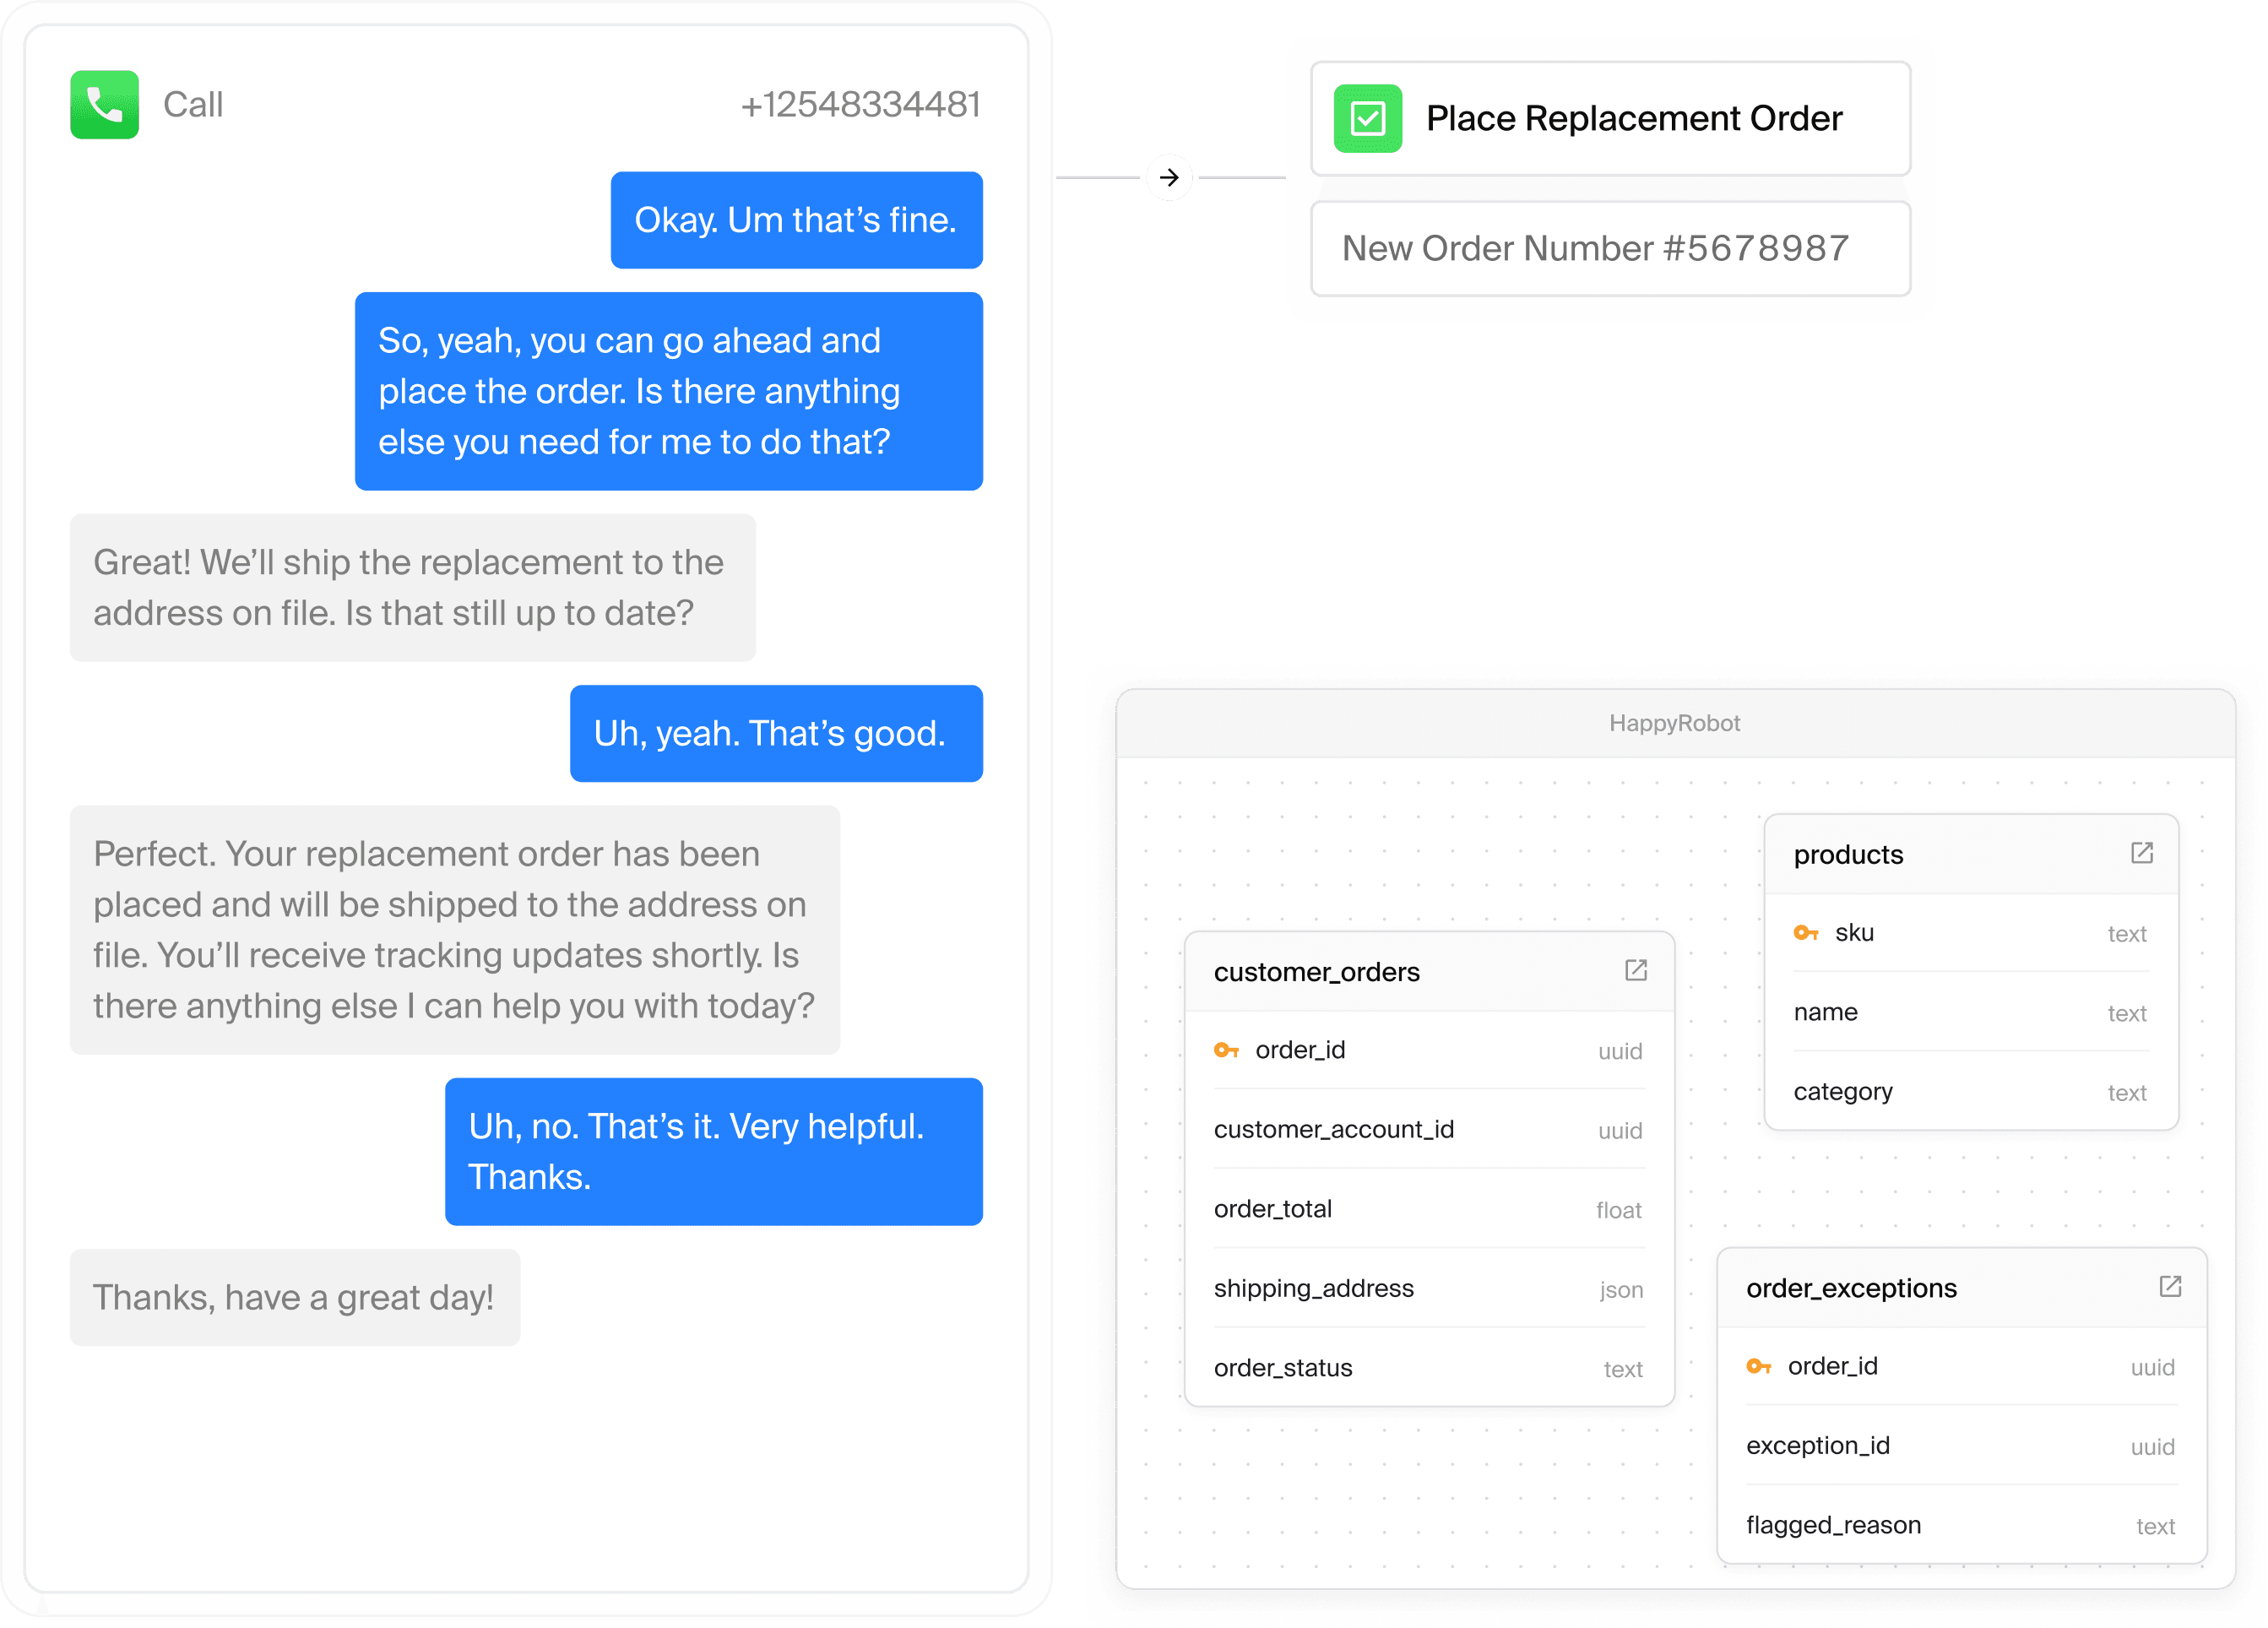
Au-delà des classifications standard comme le résultat, l'intention et le sentiment, les workflows peuvent définir et capturer toute variable qui compte pour votre activité : un prix proposé, un numéro de référence de document, une attestation de conformité, et bien plus.
Des règles d'extraction par workflow
Un workflow de support entrant extrait le statut de résolution et le motif d'escalade. Un workflow de relance sortant extrait la réponse, le type d'objection et l'action suivante. Chaque workflow définit ses propres règles d'extraction, et toutes les sorties arrivent dans la même couche de données, structurées de manière cohérente pour être comparables.
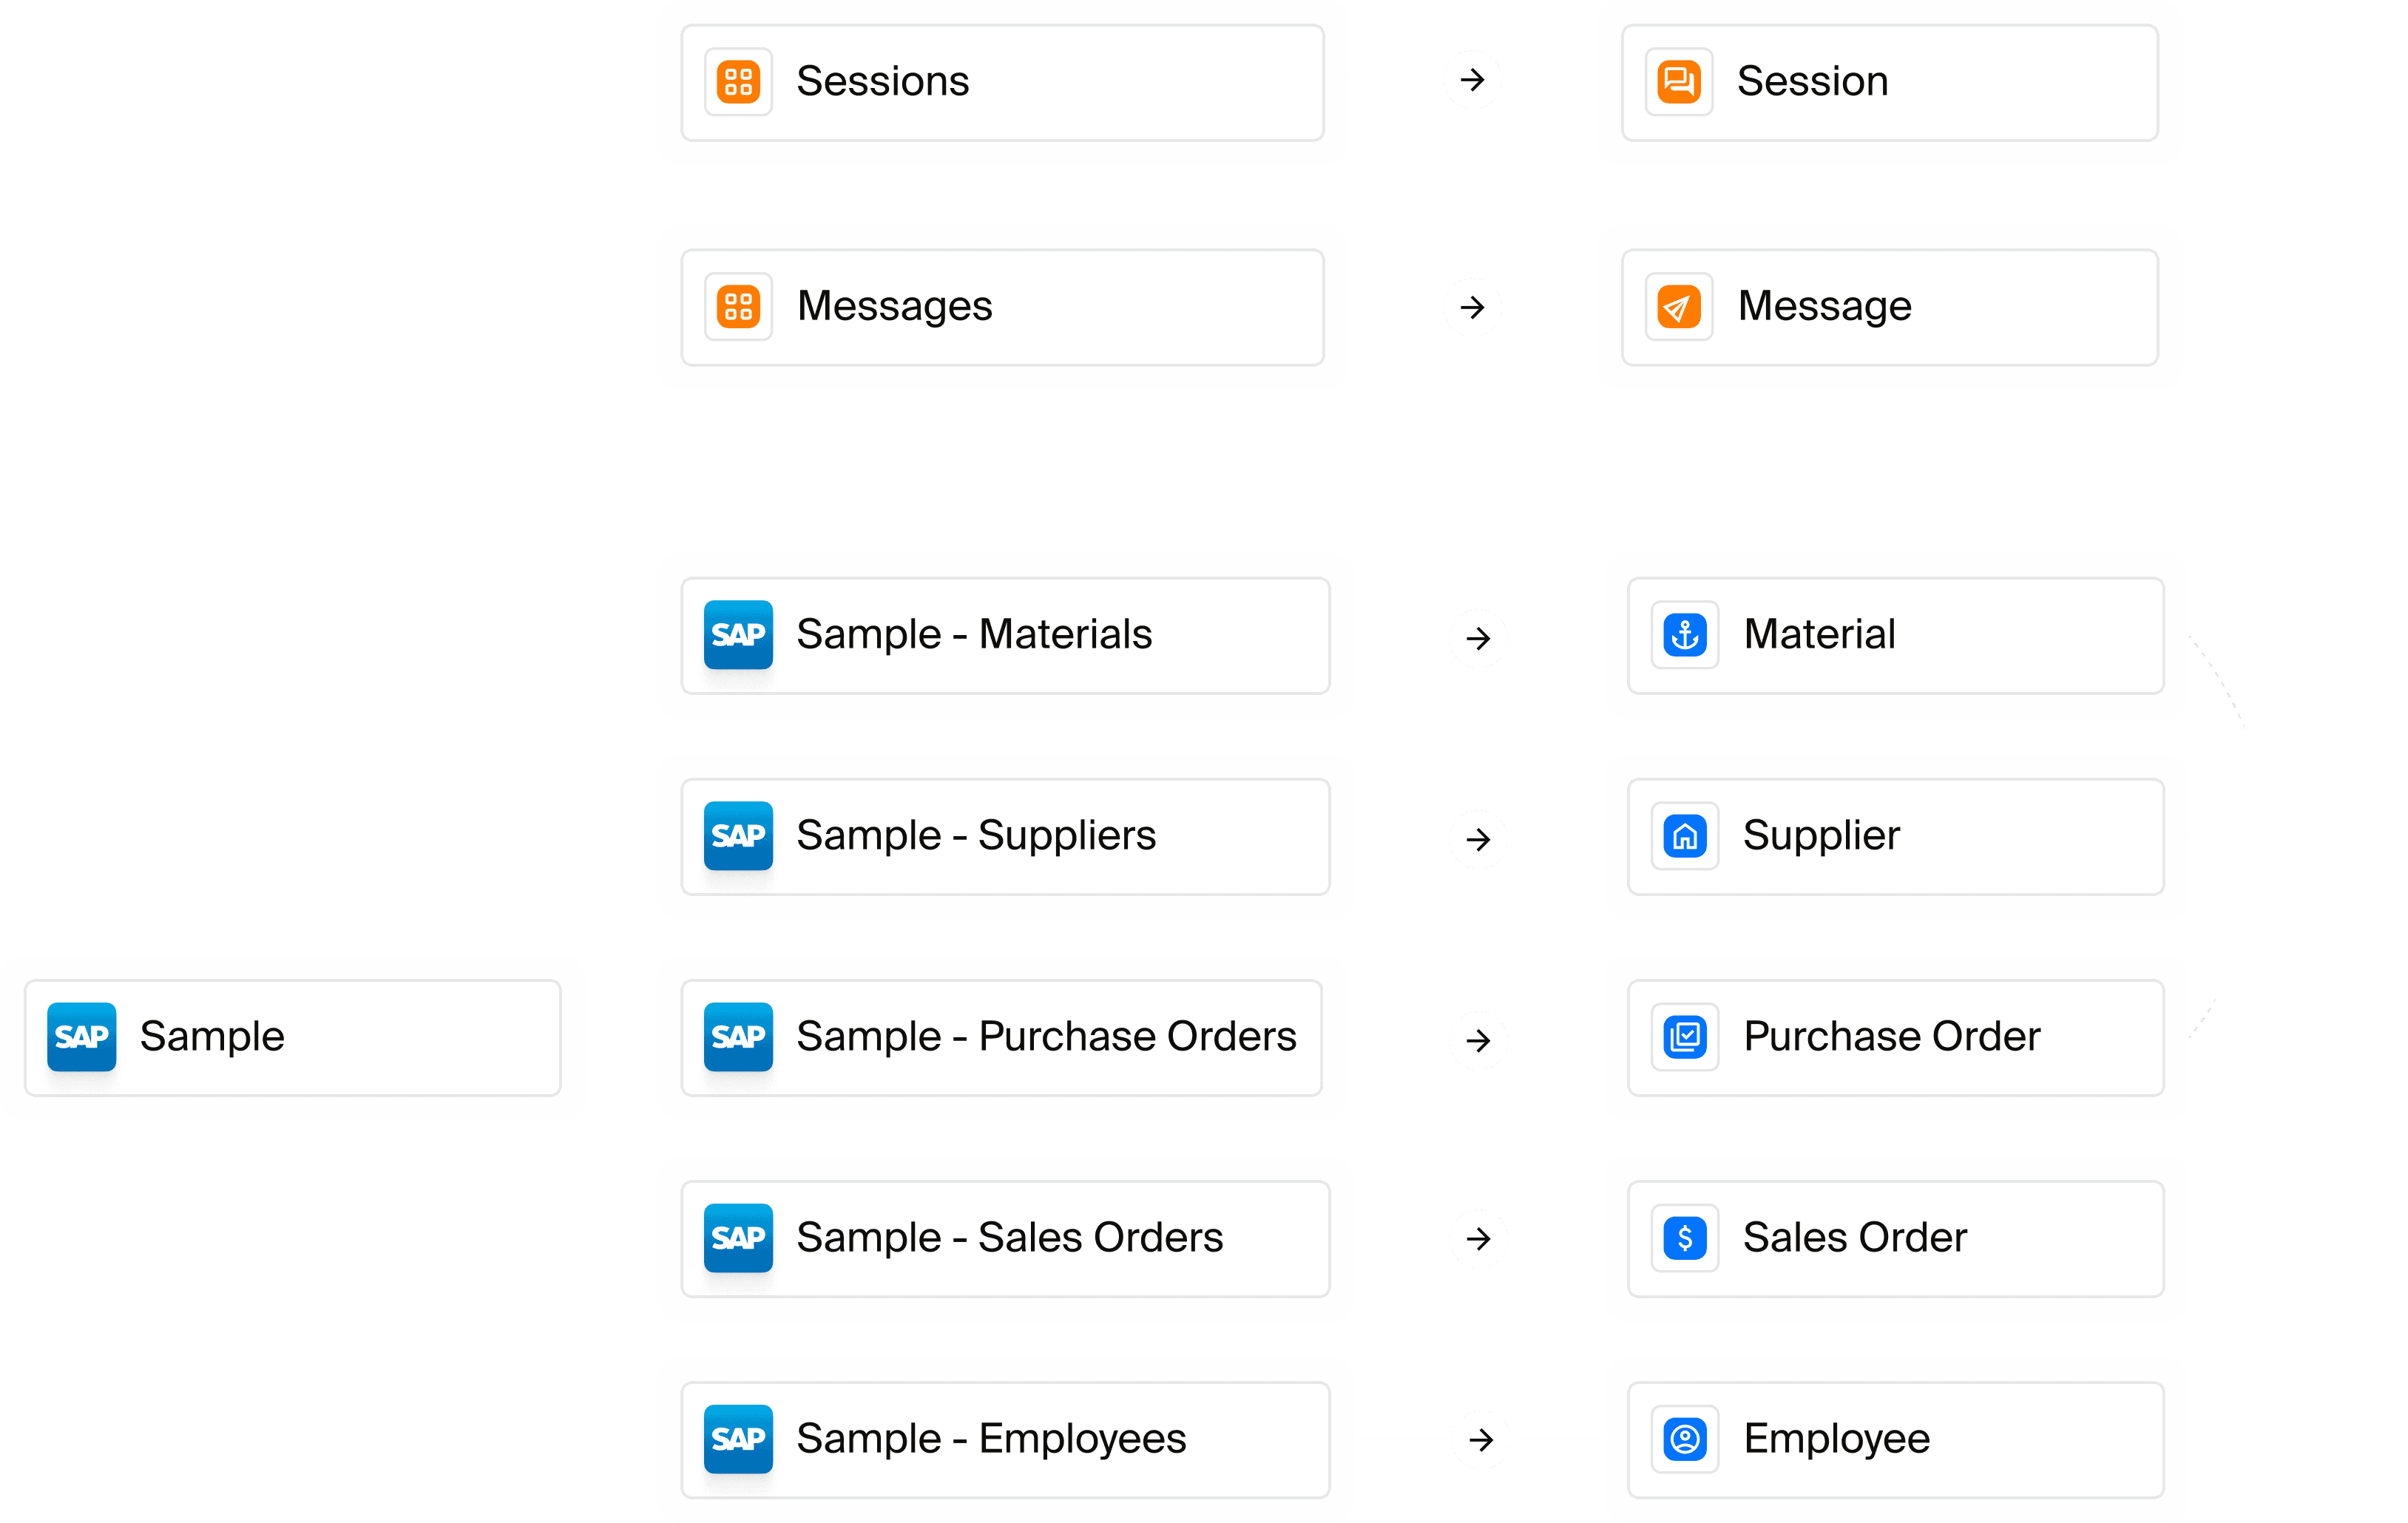
Mappage des entités
Chaque donnée capturée est automatiquement rattachée à l'entité à laquelle elle appartient : un contact, un compte, un fournisseur, un produit. La couche de données construit au fil du temps une compréhension structurée des entités clés de votre activité, au lieu d'accumuler des enregistrements non attribués.
Des données d'interaction à un enregistrement exploitable
Comment fonctionnent les extraits de mémoire
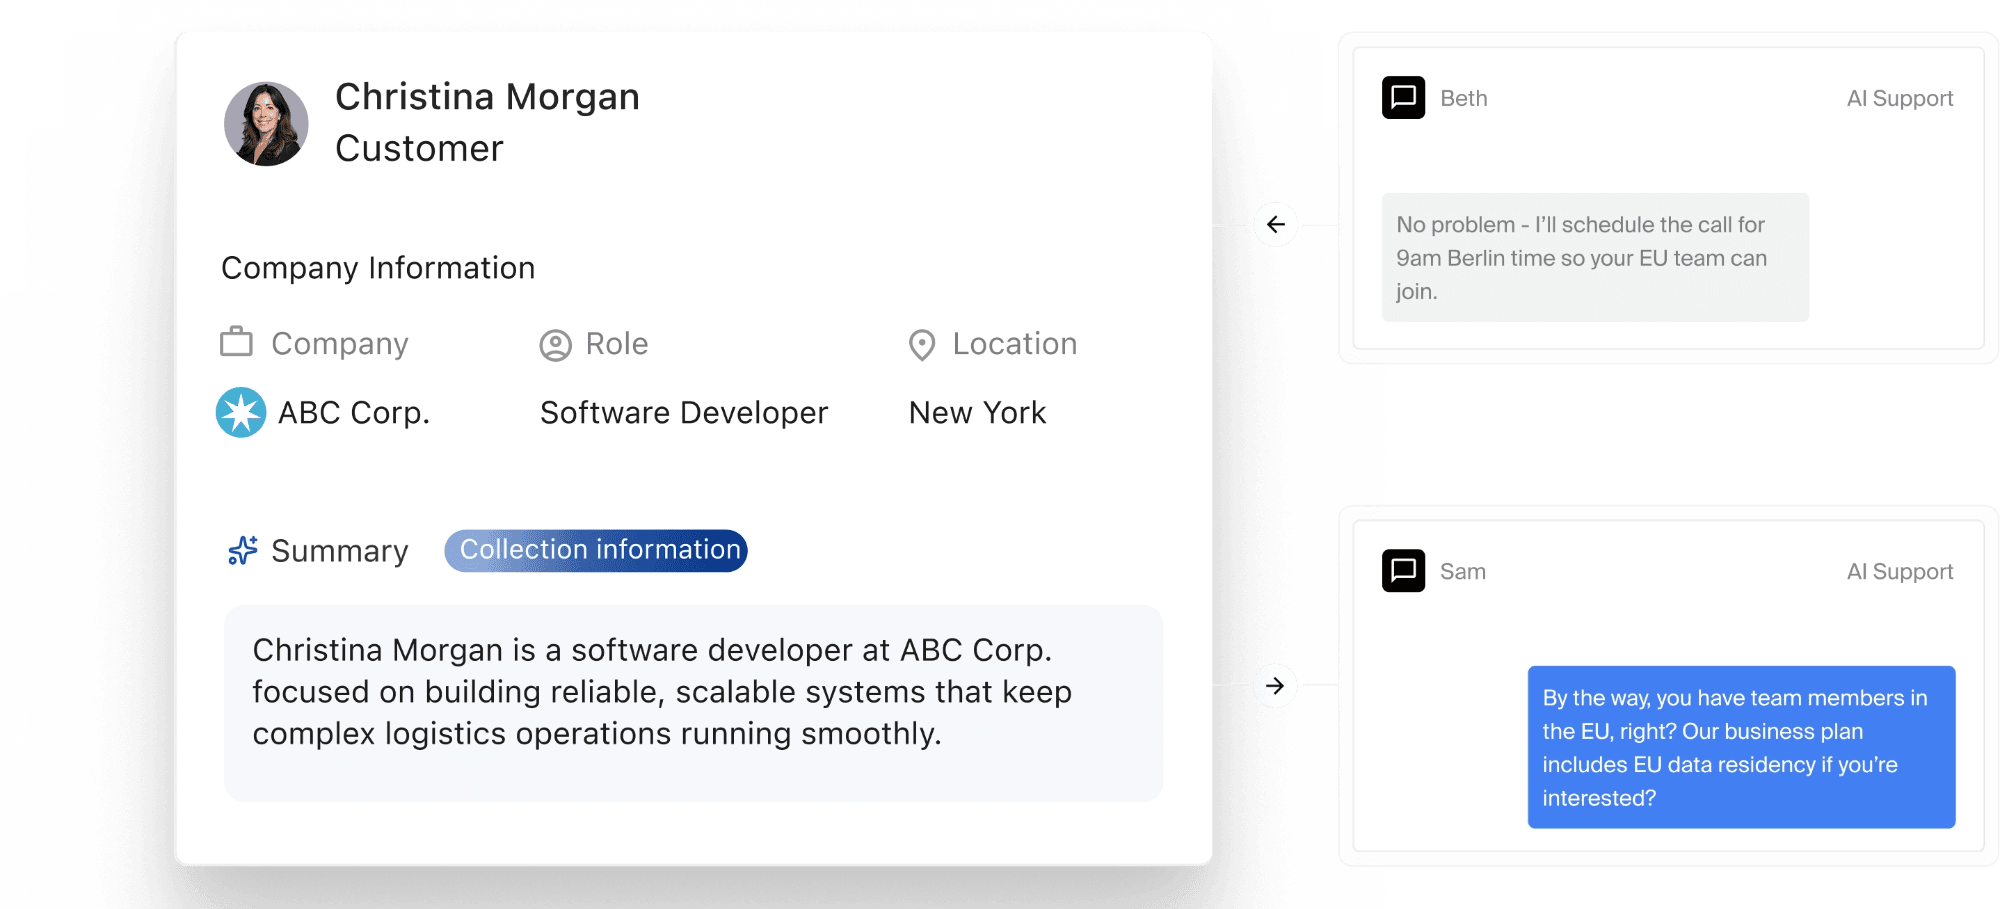
Les extraits de mémoire sont des résumés structurés des interactions passées : ce qui a réellement été discuté, résolu ou laissé en suspens. Ils sont rédigés à la fin de chaque session et indexés pour la recherche. Lorsque le même contact revient, l'agent fait remonter les extraits pertinents pour ce contexte.
Comment les tags comportementaux sont générés et utilisés
Les tags comportementaux sont dérivés de schémas observés sur plusieurs interactions : un historique d'escalade, un motif de contact récurrent, un sentiment constant, et bien d'autres. Les agents utilisent les tags comportementaux pour ajuster leur traitement avant le début d'une conversation, puis répondre ou router en conséquence.
La résolution d'identité aux extrémités
Le numéro de téléphone et l'e-mail sont les principaux points d'ancrage de l'identité : ils rattachent un appelant à son enregistrement existant avant même le premier mot prononcé. Lorsque ni l'un ni l'autre n'est disponible, des identifiants personnalisés — un numéro de suivi, un identifiant de compte, etc. — sont utilisés afin que les interactions puissent tout de même être rattachées au bon contact.
Les agents interrogent le Contexte en cours de workflow
Requêtes en cours de workflow
Les agents peuvent interroger la couche de données pendant une session en direct : récupérer une valeur capturée lors d'une interaction précédente, vérifier si une condition a déjà été remplie, consulter ce qui a été discuté lors du dernier appel d'un contact. Les agents ne traitent jamais les clients existants comme des inconnus.
Déclenchement de workflows en aval
Les données écrites dans le Contexte peuvent déclencher automatiquement des workflows en aval : un motif d'escalade capturé est routé vers un agent de relance, ou un résultat classifié lance une mise à jour du CRM. Le Contexte est une couche de données active : ce qui est capturé lors d'une interaction peut mettre la suivante en mouvement.
Conservation des données, accès et sortie de la plateforme
Conservation configurable
Les durées de conservation des données sont configurables par déploiement. Les transcriptions, les champs extraits, les enregistrements de contacts et les métadonnées de session peuvent être conservés pendant des périodes définies, alignées sur vos exigences réglementaires et opérationnelles, puis supprimés automatiquement à l'expiration de la période de conservation, sans intervention manuelle.
Isolation des locataires
Les données de chaque déploiement sont entièrement isolées. Aucune donnée n'est partagée entre locataires, utilisée pour entraîner des modèles partagés ou réutilisée à des fins étrangères au contexte d'exécution dans lequel elle a été capturée. Ce que vos agents capturent reste dans votre déploiement
Portabilité via l'API REST
L'intégralité de la couche de données est accessible via l'API REST et la passerelle REST managée, et interrogeable par des outils de BI externes, des data lakes, des plateformes d'analytique et des tableaux de bord opérationnels. Les données générées par vos agents sont traitées comme une source de données organisationnelle de premier plan, exportable et intégrable à votre stack existante selon vos conditions.